Google Hacking
Google hacking主要是通过借助谷歌搜索引擎的强大,借助特定的语法在庞大的互联网中搜索我们想要的信息
基本搜索
- 逻辑与:and
- 逻辑或: or
- 逻辑非: -
- 完整匹配:”关键词”
- 通配符:* ?
语法
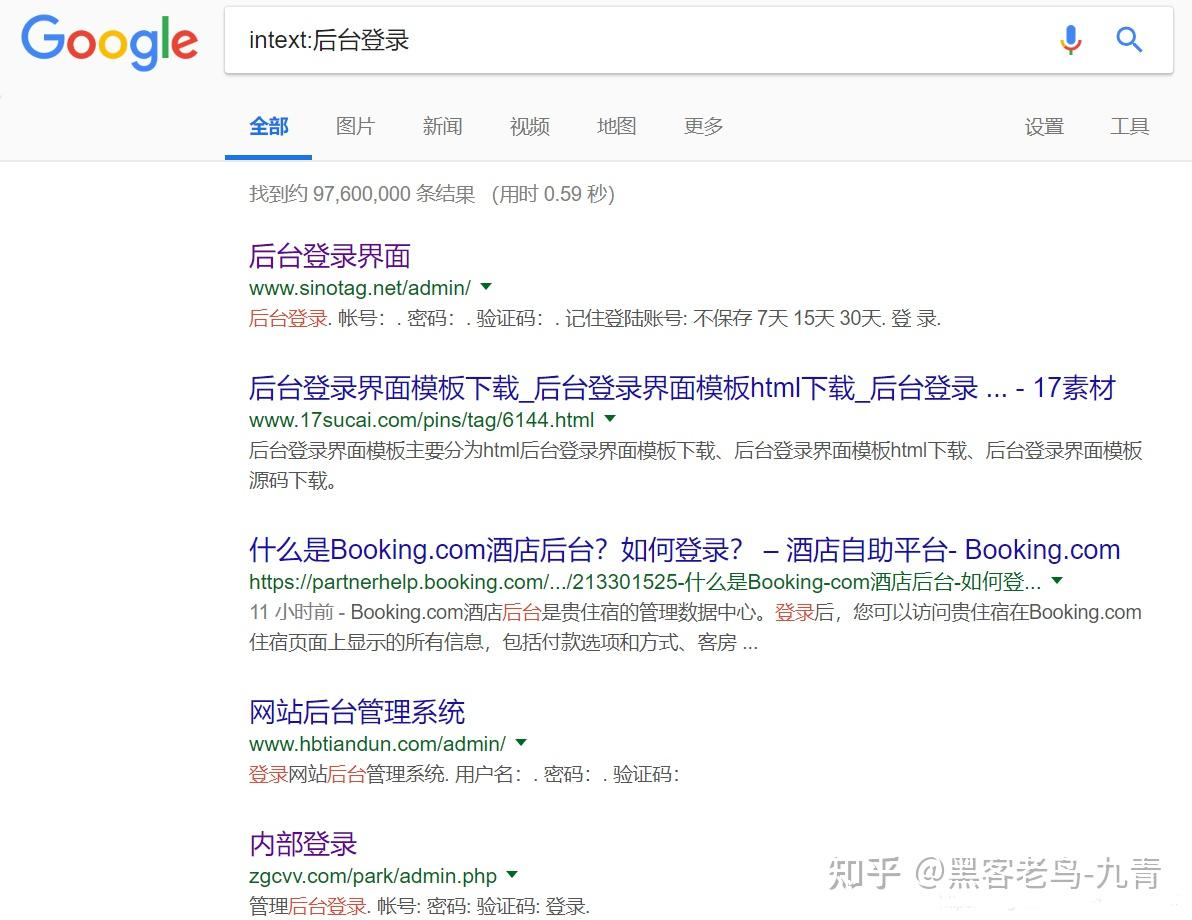
intext
寻找网页正文中存在关键字的页面:
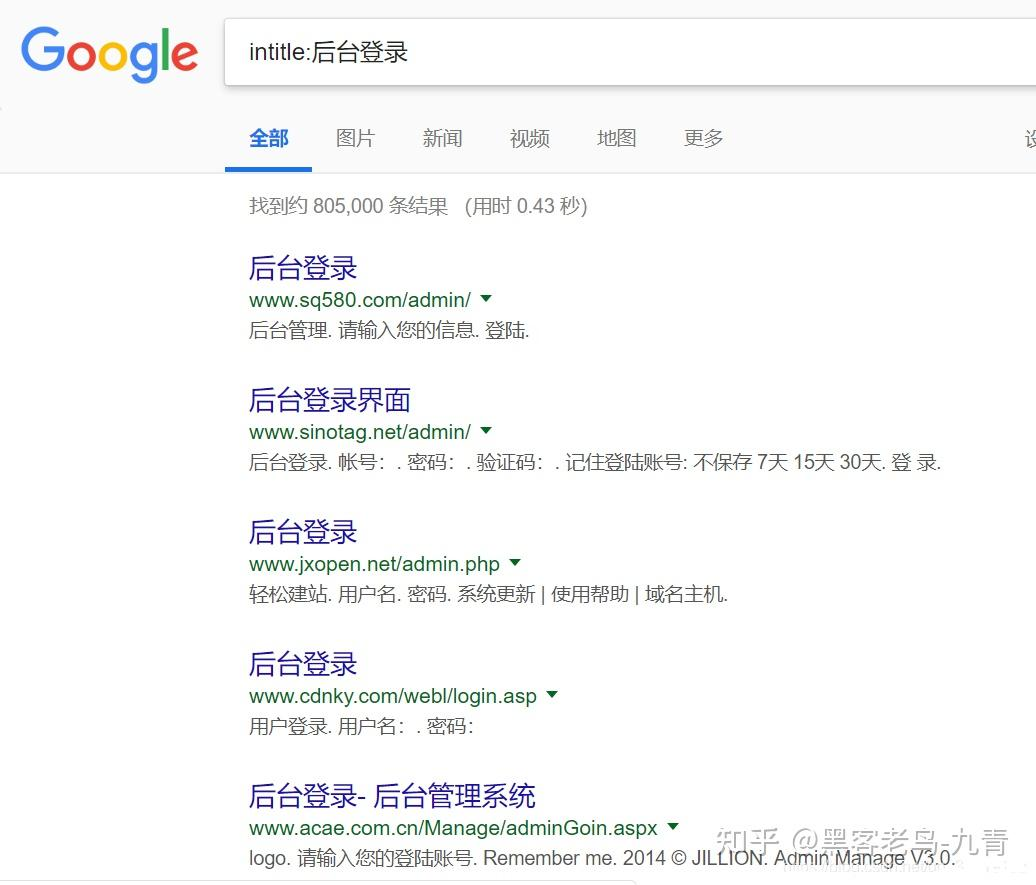
intitle
寻找标题中存在关键字的网页
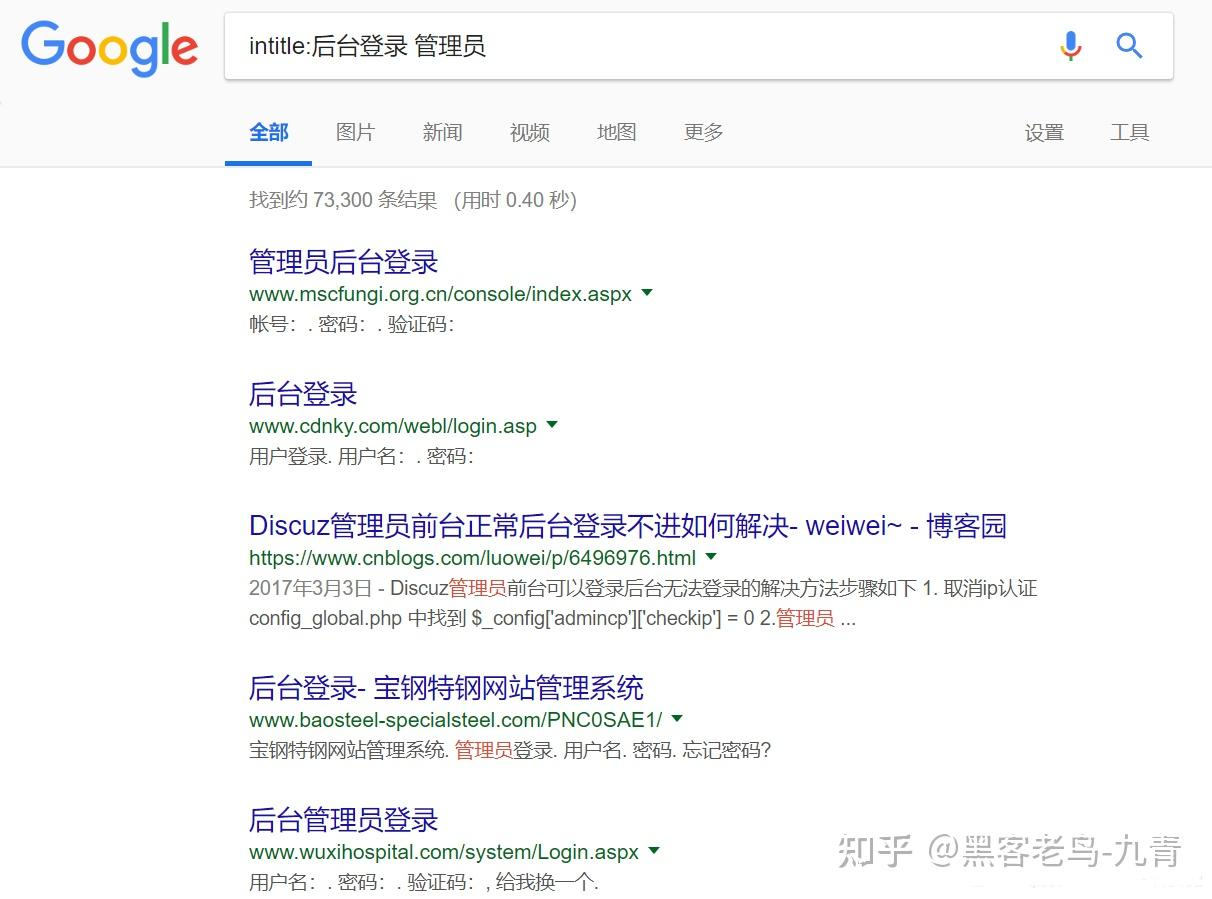
allintitle
其实就是支持多个关键词一起搜索的intitle
就比如这里我要搜索一个标题既有后台登录,同时也有管理员的网站
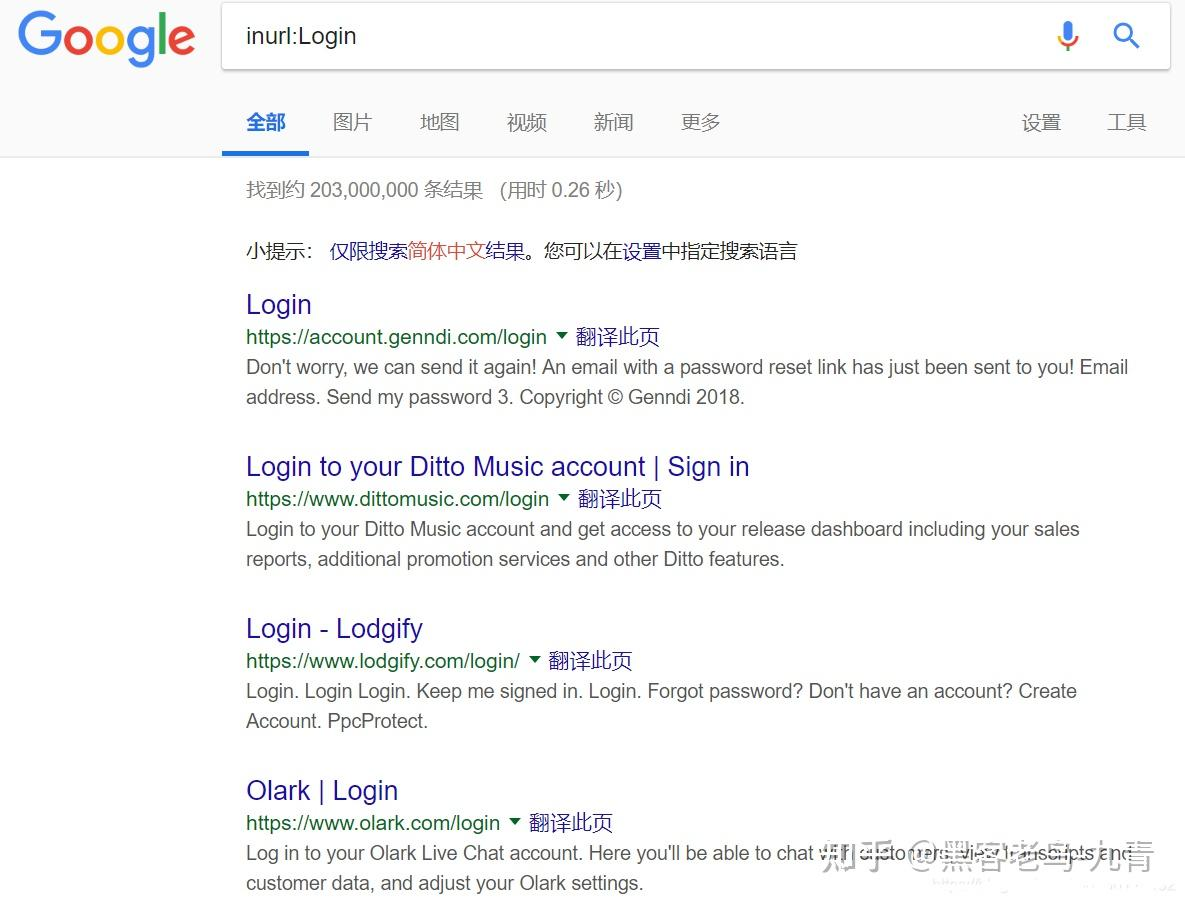
inurl
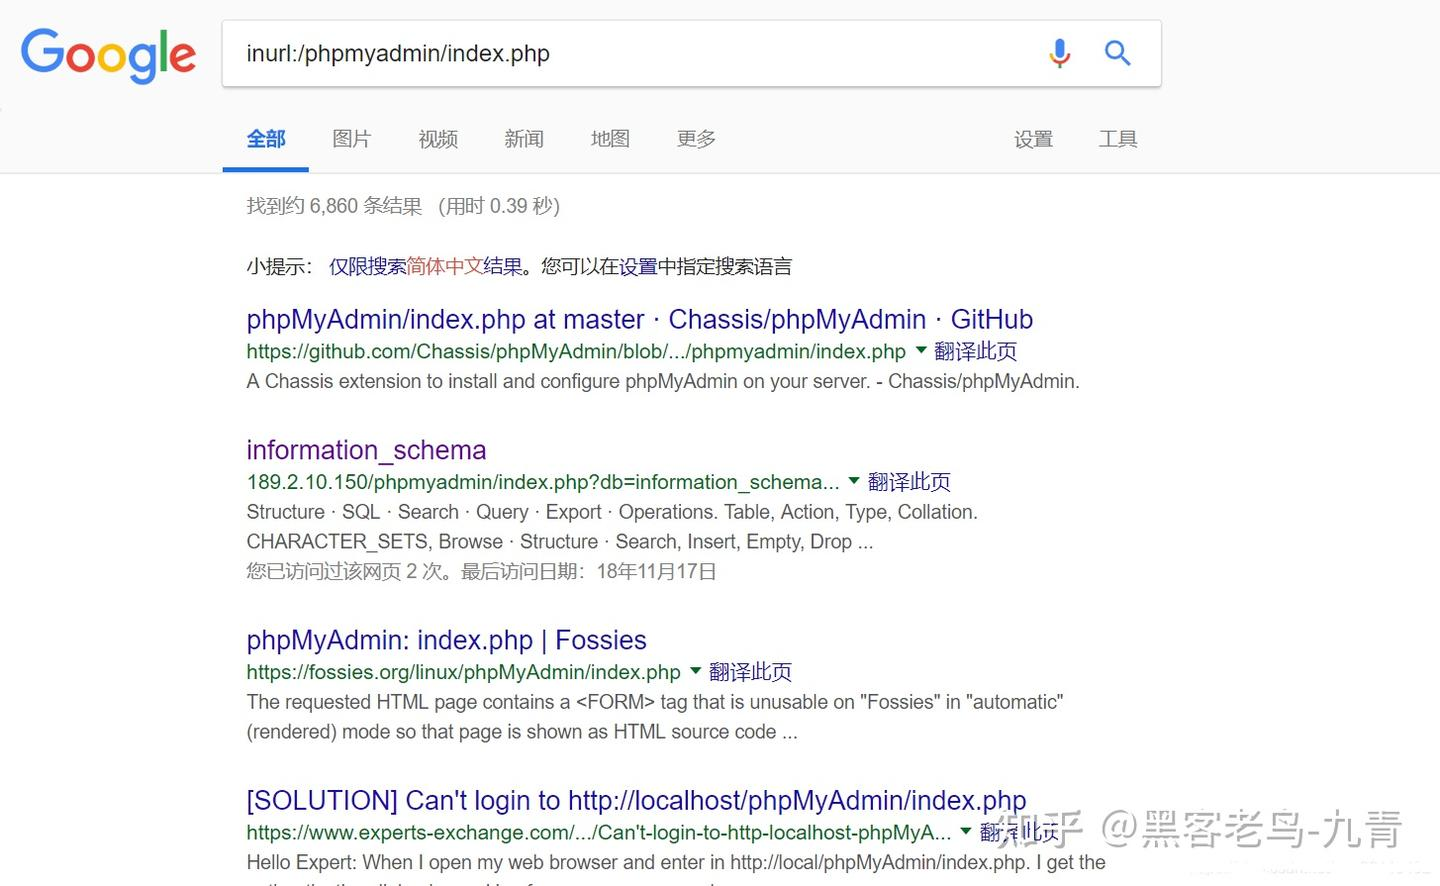
顾名思义就是去找url里面存在关键字的网站,例如:inurl:Login 将返回url中含有 Login 的网页
allinurl
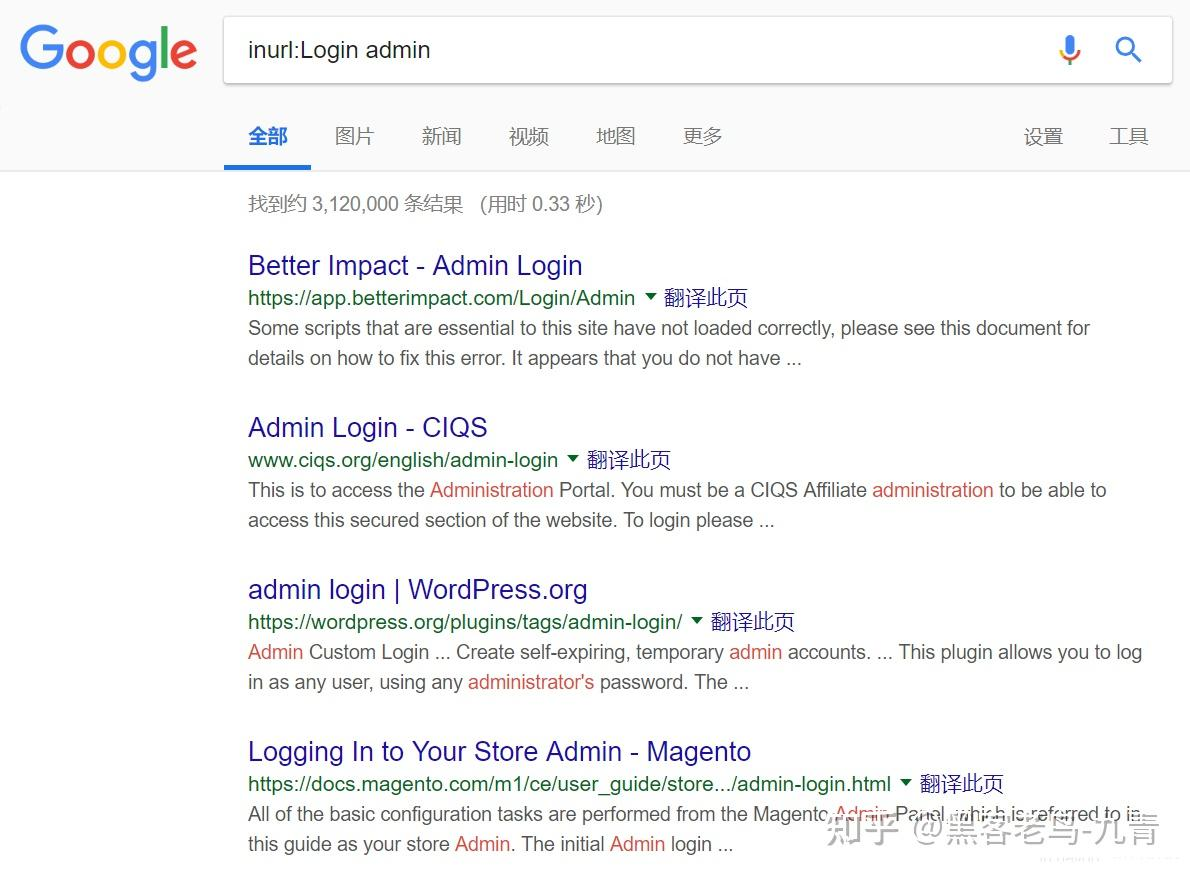
和上面allintitle一样,支持搜索多个关键词的URL
site
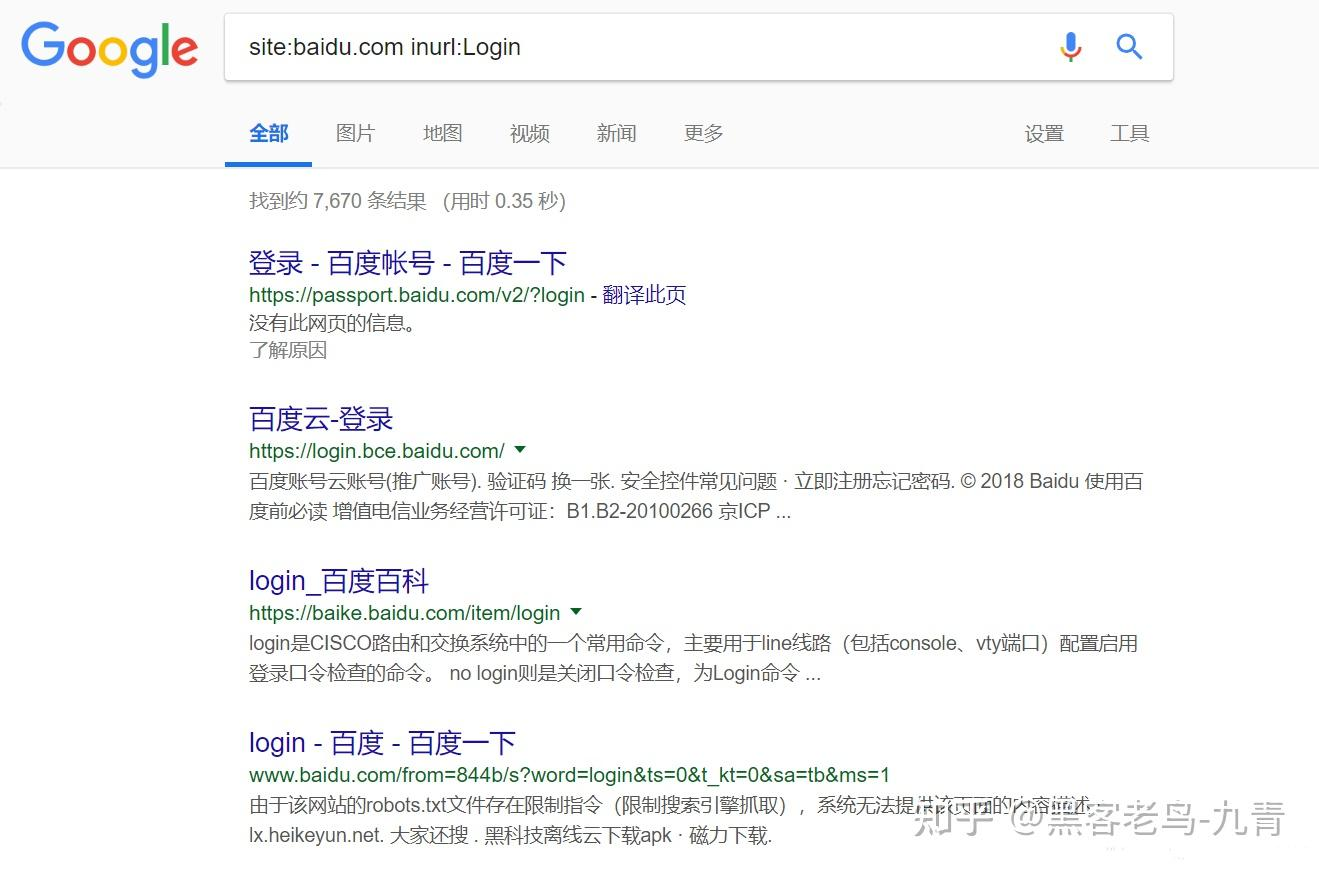
指定访问的站点,例如: site:http://baidu.com inurl:Login 将只在http://baidu.com 中查找url中含有 Login的网页
filetype
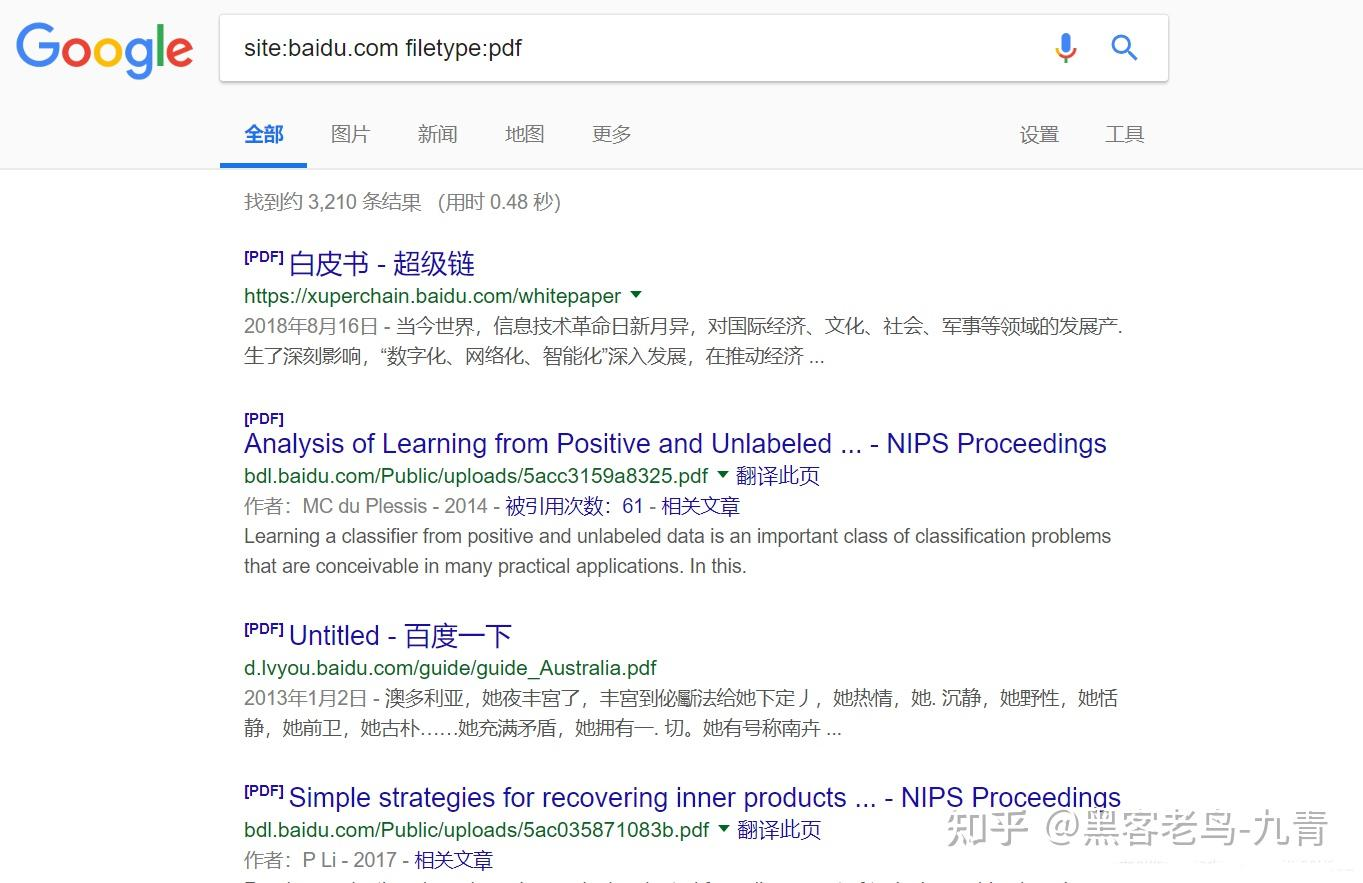
指定访问的文件类型,例如:site:http://baidu.com filetype:pdf 将只返回http://baidu.com站点上文件类型为pdf的网页
link
link:
指定链接的网页,例如:link:http://www.baidu.com 将返回所有包含指向 http://www.baidu.com 的网页
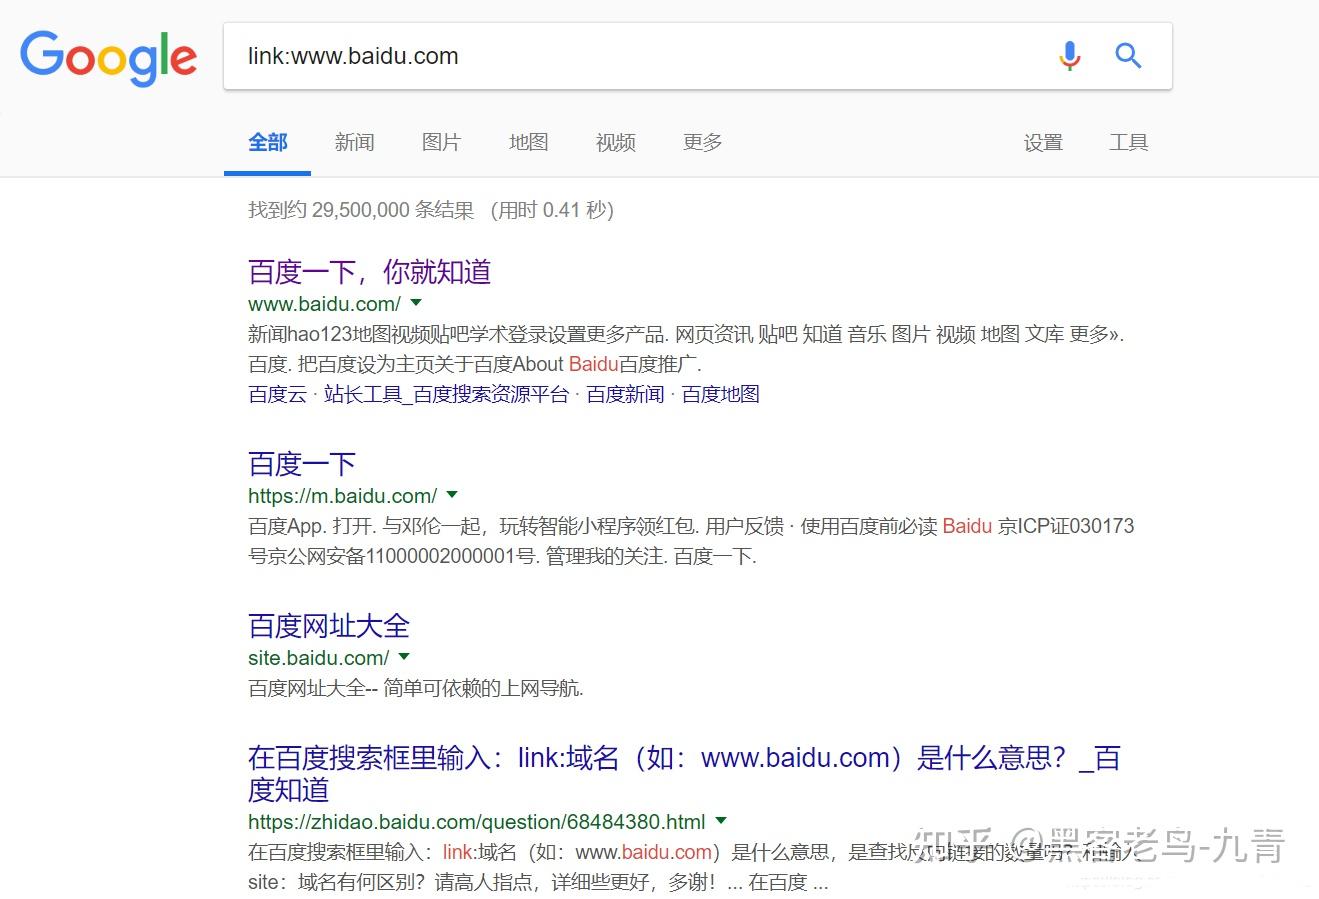
这个命令和site的区别就在于,一个向外一个向内,site是=限定目标信息的来源,去目标网址下面找而link呢则是向外找哪些网站链接了目标网站
related
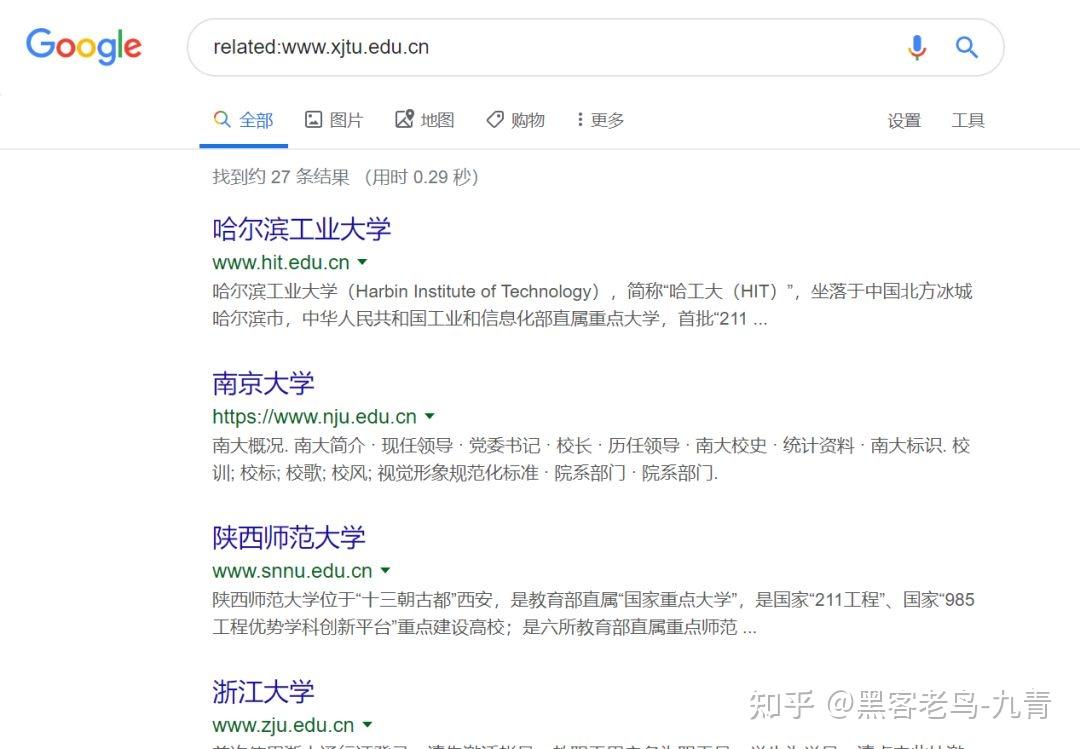
相似类型的网页,例如:related:http://www.xjtu.edu.cn 将返回与 http://www.xjtu.edu.cn 相似的页面,相似指的是网页的布局相似
cache:
网页快照,谷歌将返回给你他存储下来的历史页面,如果你同时制定了其他查询词,将在搜索结果里以高亮显示,例如:cache:http://www.hackingspirits.com guest ,将返回指定网站的缓存,并且正文中含有guest
info:
返回站点的指定信息,例如:info:http://www.baidu.com 将返回百度的一些信息
define:
返回某个词语的定义,例如:define:Hacker 将返回关于Hacker的定义
phonebook:
电话簿查询美国街道地址和电话号码信息。例如:phonebook:Lisa+CA 将返回名字里面包含Lisa并住在加州的人的所有名字
一些实战中常用的组合使用
查找网站后台
- site:http://xx.com intext:管理
- site:http://xx.com inurl:login
- site:http://xx.com intitle:后台
查看服务器使用的程序
- site:http://xx.com filetype:asp
- site:http://xx.com filetype:php
- site:http://xx.com filetype:jsp
- site:http://xx.com filetype:aspx
查看上传漏洞
- site:http://xx.com inurl:file
- site:http://xx.com inurl:load
index of
利用 Index of 语法去发现允许目录浏览的web网站,就像在本地的普通目录一样。下面是一些有趣的查询:
- index of /admin
- index of /passwd
- index of /password
- index of /mail
- “index of /“ +passwd
- “index of /“ +password.txt
- “index of /“ +.htaccess
- “index of /root”
- “index of /cgi-bin”
- “index of /logs”
- “index of /config”
其实这个东西本质就是管理员如果没能够进行正确的配置
- 核心本质
- 不是黑客指令: 它只是配置错误的 Web 服务器(忘记放
index.html且开启了目录浏览)自动生成的网页的默认标题。 - 相当于什么: 相当于别人把存放机密文件的 U 盘,毫无防备地插在了公共电脑上。
- 搜索公式
万能句式:intitle:"index of" "你要找的特定文件或文件夹名" (注意:务必使用双引号,强制谷歌进行一字不差的精确匹配)
- 实战寻宝指南
- 找源代码 (终极杀器):
intitle:"index of" ".git"(找 Git 源码库,直接扒全站代码)intitle:"index of" ".svn"(找 SVN 源码库)
- 找数据库 & 备份 (直接拿数据):
intitle:"index of" "database.sql"(找 SQL 导出文件)intitle:"index of" "users.db"(找 SQLite 数据库文件)intitle:"index of" "backup.zip" | "wwwroot.tar.gz"(找网站源码打包备份)
- 找配置文件 & 密码 (拿权限):
intitle:"index of" ".env"(找环境变量,里面通常有数据库密码或云密钥)intitle:"index of" "id_rsa"(找 SSH 私钥,尝试免密登录服务器)intitle:"index of" "password.txt"(最简单粗暴的密码本)
- 找敏感日志 (找线索和后台接口):
intitle:"index of" "error.log"(报错日志,常包含绝对路径和 SQL 报错)intitle:"index of" "access.log"(访问日志,可以分析出隐藏的 API 接
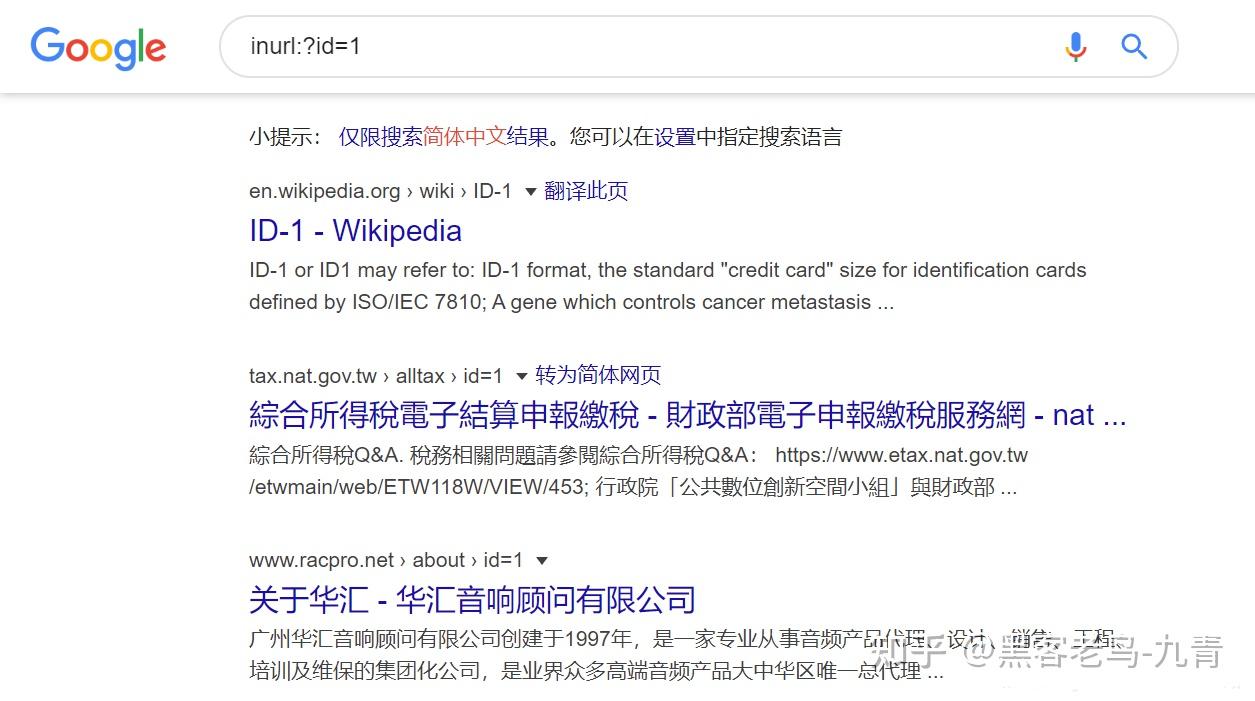
查找有可能存在SQL注入的网站
inurl:id=1
空间测绘引擎
语法
这里就以fofa为例:
| 逻辑连接符 | 具体含义 |
|---|---|
| = | 匹配,=””时,可查询不存在字段或者值为空的情况。 |
|---|---|
| == | 完全匹配,==””时,可查询存在且值为空的情况。 |
| && | 与 |
| || | 或 |
| != | 不匹配,!=””时,可查询值不为空的情况。 |
| *= | 模糊匹配,使用*或者?进行搜索。 |
| () | 确认查询优先级,括号内容优先级最高。 |
基础查询语法:
| ip | ip=”1.1.1.1” | 通过单一IPv4地址进行查询 | ✓ | ✓ | - |
|---|---|---|---|---|---|
| ip=”220.181.111.1/24” | 通过IPv4 C段进行查询 | ✓ | ✓ | - | |
| ip=”2600:9000:202a:2600:18:4ab7:f600:93a1” | 通过单一Ipv6地址进行查询 | ✓ | ✓ | - | |
| port | port=”6379” | 通过端口号进行查询 | ✓ | ✓ | ✓ |
| domain | domain=”qq.com” | 通过根域名进行查询 | ✓ | ✓ | ✓ |
| host | host=”.fofa.info” | 通过主机名进行查询 | ✓ | ✓ | ✓ |
| os | os=”centos” | 通过操作系统进行查询 | ✓ | ✓ | ✓ |
| server | server=”Microsoft-IIS/10” | 通过服务器进行查询 | ✓ | ✓ | ✓ |
| asn | asn=”19551” | 通过自治系统号进行搜索 | ✓ | ✓ | ✓ |
| org | org=”LLC Baxet” | 通过所属组织进行查询 | ✓ | ✓ | ✓ |
| is_domain | is_domain=true | 筛选拥有域名的资产 | ✓ | - | - |
| is_domain=false | 筛选没有域名的资产 | ✓ | - | - | |
| is_ipv6 | is_ipv6=true | 筛选是ipv6的资产 | ✓ | - | - |
| is_ipv6=false | 筛选是ipv4的资产 |
其中关于ip相关的查询再进行查询:
第一种的ip查询就是知道了网站的具体ip,这种就是最精确的ip搜索
第二种就是就是扫c段
这是什么: 这是渗透测试里最常用的高阶技巧之一。这里的 /24 叫做 CIDR(无类别域间路由) 表示法。它不再是搜一个 IP,而是搜一整个网段(共 256 个 IP)。
什么是 C段 (C段渗透): /24 意味着 IP 地址的前 24 位(即前三个数字 220.181.111)是固定不变的,只有最后一个数字在变(从 0 变到 255)。所以这条命令实际上是在搜从 220.181.111.0 到 220.181.111.255 这 256 个 IP 上的所有资产。
就比如127.0.0.1里面,127就是a段,0就是b段,再往后的那个0就是c段了
实战场景 (为什么黑客爱扫C段?): 企业的 IT 部门在购买公网 IP 时,通常是一段一段买的。如果你发现目标公司的官网在 220.181.111.15,并且它的防御非常变态,你根本打不进去。怎么办? 你可以去搜它的 C段!很可能 .16 是他们无人打理的测试服务器,.17 是有漏洞的旧版 OA 系统,.18 是员工的 VPN 入口。只要拿下同网段的任何一台边缘机器,你就可以以此为跳板,直接打入企业内网(内网漫游)。
第三种就是第一种其实,只不过使用的地址是新一代的ipv6地址
标记类(Special Label)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| app | app=”Microsoft-Exchange” | 通过FOFA整理的规则进行查询 | ✓ | - | - |
|---|---|---|---|---|---|
| fid | fid=”sSXXGNUO2FefBTcCLIT/2Q==” | 通过FOFA聚合的站点指纹进行查询 | ✓ | ✓ | - |
| product | product=”NGINX” | 通过FOFA标记的产品名进行查询 | ✓ | ✓ | - |
| product.version | product=”Roundcube-Webmail” && product.version=”1.6.10” | 通过FOFA标记的产品版本号进行查询 | ✓ | ✓ | - |
| category | category=”服务” | 通过FOFA标记的分类进行查询 | ✓ | ✓ | - |
| type | type=”service” | 筛选协议资产 | ✓ | - | - |
| type=”subdomain” | 筛选服务(网站类)资产 | ✓ | - | - | |
| cloud_name | cloud_name=”Aliyundun” | 通过云服务商进行查询 | ✓ | ✓ | ✓ |
| is_cloud | is_cloud=true | 筛选是云服务的资产 | ✓ | - | - |
| is_cloud=false | 筛选不是云服务的资产 | ✓ | - | - | |
| is_fraud | is_fraud=true | 筛选是仿冒垃圾站群的资产 (专业版及以上) | ✓ | - | - |
| is_fraud=false | 筛选不是仿冒垃圾站群的资产(已默认筛选) | ✓ | - | - | |
| is_honeypot | is_honeypot=true | 筛选是蜜罐的资产 (专业版及以上) | ✓ | - | - |
| is_honeypot=false | 筛选不是蜜罐的资产(已默认筛选) | ✓ | - | - |
协议类 (type=service)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| protocol | protocol=”quic” | 通过协议名称进行查询 | ✓ | ✓ | ✓ |
|---|---|---|---|---|---|
| banner | banner=”users” | 通过协议返回信息进行查询 (注册用户及以上) | ✓ | ✓ | - |
| banner_hash | banner_hash=”7330105010150477363” | 通过协议响应体计算的hash值进行查询 (个人版及以上) | ✓ | ✓ | - |
| banner_fid | banner_fid=”zRpqmn0FXQRjZpH8MjMX55zpMy9SgsW8” | 通过协议返回信息结构计算的指纹值进行查询。 (个人版及以上) | ✓ | ✓ | - |
| base_protocol | base_protocol=”udp” | 查询传输层为udp协议的资产 | ✓ | ✓ | - |
| base_protocol=”tcp” | 查询传输层为tcp协议的资产 | ✓ | ✓ | - |
网站类(type=subdomain)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| title | title=”beijing” | 通过网站标题进行查询 | ✓ | ✓ | ✓ |
|---|---|---|---|---|---|
| header | header=”elastic” | 通过响应标头进行查询 (注册用户及以上) | ✓ | ✓ | - |
| header_hash | header_hash=”1258854265” | 通过http/https响应头计算的hash值进行查询 (个人版及以上) | ✓ | ✓ | ✓ |
| body | body=”网络空间测绘” | 通过HTML正文进行查询 (注册用户及以上) | ✓ | ✓ | - |
| body_hash | body_hash=”-2090962452” | 通过HTML正文计算的hash值进行查询 | ✓ | ✓ | - |
| js_name | js_name=”js/jquery.js” | 通过HTML正文包含的JS进行查询 | ✓ | ✓ | ✓ |
| js_md5 | js_md5=”82ac3f14327a8b7ba49baa208d4eaa15” | 通过JS源码进行查询 | ✓ | ✓ | ✓ |
| cname | cname=”customers.spektrix.com” | 通过别名记录进行查询 | ✓ | ✓ | ✓ |
| cname_domain | cname_domain=”siteforce.com” | 通过别名记录解析的主域名进行查询 | ✓ | ✓ | ✓ |
| icon_hash | icon_hash=”-247388890” | 通过网站图标的hash值进行查询 | ✓ | ✓ | - |
| status_code | status_code=”402” | 筛选服务状态为402的服务(网站)资产 | ✓ | ✓ | - |
| icp | icp=”京ICP证030173号” | 通过HTML正文包含的ICP备案号进行查询 | ✓ | ✓ | ✓ |
| sdk_hash | sdk_hash=”Are3qNnP2Eqn7q5kAoUO3l+w3mgVIytO” | 通过网站嵌入的第三方代码计算的hash值进行查询 (商业版及以上) | ✓ | ✓ | - |
地理位置(Location)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| country | country=”CN” | 通过国家的简称代码进行查询 | ✓ | ✓ | - |
|---|---|---|---|---|---|
| country=”中国” | 通过国家中文名称进行查询 | ✓ | ✓ | - | |
| region | region=”Zhejiang” | 通过省份/地区英文名称进行查询 | ✓ | ✓ | - |
| region=”浙江” | 通过省份/地区中文名称进行查询(仅支持中国地区) | ✓ | ✓ | - | |
| city | city=”Hangzhou” | 通过城市英文名称进行查询 | ✓ | ✓ | - |
证书类(Certificate)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| cert | cert=”baidu” | 通过证书进行查询 (注册用户及以上) | ✓ | ✓ | - |
|---|---|---|---|---|---|
| cert.subject | cert.subject=”Oracle Corporation” | 通过证书的持有者进行查询 | ✓ | ✓ | ✓ |
| cert.issuer | cert.issuer=”DigiCert” | 通过证书的颁发者进行查询 | ✓ | ✓ | ✓ |
| cert.subject.org | cert.subject.org=”Oracle Corporation” | 通过证书持有者的组织进行查询 | ✓ | ✓ | ✓ |
| cert.subject.cn | cert.subject.cn=”baidu.com” | 通过证书持有者的通用名称进行查询 | ✓ | ✓ | ✓ |
| cert.issuer.org | cert.issuer.org=”cPanel, Inc.” | 通过证书颁发者的组织进行查询 | ✓ | ✓ | ✓ |
| cert.issuer.cn | cert.issuer.cn=”Synology Inc. CA” | 通过证书颁发者的通用名称进行查询 | ✓ | ✓ | ✓ |
| cert.domain | cert.domain=”huawei.com” | 通过证书持有者的根域名进行查询 | ✓ | ✓ | ✓ |
| cert.is_equal | cert.is_equal=true | 筛选证书颁发者和持有者匹配的资产 (个人版及以上) | ✓ | - | - |
| cert.is_equal=false | 筛选证书颁发者和持有者不匹配的资产 (个人版及以上) | ✓ | - | - | |
| cert.is_valid | cert.is_valid=true | 筛选证书是有效证书的资产 (个人版及以上) | ✓ | - | - |
| cert.is_valid=false | 筛选证书是无效证书的资产 (个人版及以上) | ✓ | - | - | |
| cert.is_match | cert.is_match=true | 筛选证书和域名匹配的资产 (个人版及以上) | ✓ | - | - |
| cert.is_match=false | 筛选证书和域名不匹配的资产 (个人版及以上) | ✓ | - | - | |
| cert.is_expired | cert.is_expired=true | 筛选证书已过期的资产 (个人版及以上) | ✓ | - | - |
| cert.is_expired=false | 筛选证书未过期的资产 (个人版及以上) | ✓ | - | - | |
| jarm | jarm=”2ad2ad0002ad2ad22c2ad2ad2ad2ad2eac92ec34bcc0cf7520e97547f83e81” | 通过JARM指纹进行查询 | ✓ | ✓ | ✓ |
| tls.version | tls.version=”TLS 1.3” | 通过tls的协议版本进行查询 | ✓ | ✓ | - |
| tls.ja3s | tls.ja3s=”15af977ce25de452b96affa2addb1036” | 通过tls的ja3s指纹进行查询 | ✓ | ✓ | ✓ |
| cert.sn | cert.sn=”356078156165546797850343536942784588840297” | 通过证书序列号进行查询 | ✓ | ✓ | - |
| cert.not_after.after | cert.not_after.after=”2025-03-01” | 筛选某证书到期日期后的证书 | ✓ | - | - |
| cert.not_after.before | cert.not_after.before=”2025-03-01” | 筛选某证书到期日期前的证书 | ✓ | - | - |
| cert.not_before.after | cert.not_before.after=”2025-03-01” | 筛选某证书生效日期后的证书 | ✓ | - | - |
| cert.not_before.before | cert.not_before.before=”2025-03-01” | 筛选某证书生效日期前的证书 | ✓ | - | - |
时间类(Last update time)
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| after | after=”2023-01-01” | 筛选某一时间之后有更新的资产 (个人版及以上) | ✓ | - | - |
|---|---|---|---|---|---|
| before | before=”2023-12-01” | 筛选某一时间之前有更新的资产 (个人版及以上) | ✓ | - | - |
| after&before | after=”2023-01-01” && before=”2023-12-01” | 筛选某一时间区间有更新的资产 (个人版及以上) | ✓ | - | - |
独立IP语法,需配合ip_filter或ip_exclude组合使用
| 语法 | 例句 | 用途说明 | = | != | *= |
|---|---|---|---|---|---|
| ip_filter() | ip_filter(banner=”SSH-2.0-OpenSSH_6.7p2”) && ip_filter(icon_hash=”-1057022626”) | 同源IP多资产特征匹配 (商业版及以上) | ✓ | - | - |
|---|---|---|---|---|---|
| ip_exclude() | ip_filter(banner=”SSH-2.0-OpenSSH_6.7p2” && asn=”3462”) && ip_exclude(title=”EdgeOS”) | 同源IP多资产特征不匹配 (商业版及以上) | ✓ | - | - |
| port_size | port_size=”6” | 筛选开放端口数量等于6个的独立IP (商业版及以上) | ✓ | ✓ | - |
| port_size_gt | port_size_gt=”6” | 筛选开放端口数量大于6个的独立IP (商业版及以上) | ✓ | - | - |
| port_size_lt | port_size_lt=”12” | 筛选开放端口数量小于12个的独立IP (商业版及以上) | ✓ | - | - |
| ip_ports | ip_ports=”80,161” | 筛选同时开放不同端口的独立IP (商业版及以上) | ✓ | - | - |
| ip_country | ip_country=”CN” | 通过国家的简称代码进行查询独立IP (商业版及以上) | ✓ | - | - |
| ip_region | ip_region=”Zhejiang” | 通过省份/地区英文名称进行查询独立IP (商业版及以上) | ✓ | - | - |
| ip_city | ip_city=”Hangzhou” | 通过城市英文名称进行查询独立IP (商业版及以上) | ✓ | - | - |
| ip_after | ip_after=”2021-03-18” | 筛选某一时间之后有更新的独立IP (商业版及以上) | ✓ | - | - |
| ip_before | ip_before=”2019-09-09” | 筛选某一时间之前有更新的独立IP (商业版及以上) | ✓ | - | - |
子域名收集
首先要知道子域名是什么
子域名是指顶级域名(一级域名)的下一级域名,如mail.qq.com和www.qq.com都是qq.com的子域。从旁站查找漏洞往往比主站容易,因此子域名信息的收集显得尤为重要。其中qq.com就是这一系列子域名的主域名
工具的使用
oneforall
开启:
1 | cd ~/Desktop/渗透学习/tool/OneForAll |
关闭:
1 | deactivate |
| 字段名 (Column) | 含义 (Meaning) | 渗透测试中的价值 (Hacker’s View) |
|---|---|---|
url |
完整访问路径 | 直接拿来访问的地址,注意协议是 http 还是 https。 |
subdomain |
子域名 | 资产的名字。前缀通常暗示了功能(如 dev 代表开发,test 代表测试)。 |
ip |
服务器 IP | 攻击的物理目标。如果多域名指向同一 IP,说明是同服站点。 |
port |
开放端口 | 门窗位置。非 80/443 的端口(如 8080, 8116)防御通常较弱。 |
status |
HTTP 状态码 | 200 表示活着;403 可能有 WAF;302 说明有跳转。 |
title |
网页标题 | 最关键! 帮你快速筛选“后台”、“登录”、“管理”、“上传”等高价值目标。 |
banner |
服务头信息 | 暴露服务器中间件版本(如 Nginx/1.18),用来找特定版本的 CVE 漏洞。 |
cidr |
C段网段 | 告诉你邻居在哪。如果目标打不动,可以去打它整个 C 段(/24)。 |
cdn |
是否用 CDN | 1 表示有 CDN,看到的 IP 是假的;0 表示可能是真实 IP。 |
source |
发现来源 | 告诉你这个域名是怎么找到的。brute 代表爆破出来的,通常更隐蔽。 |
org |
所属机构 | 确认这台机器是学校机房的,还是租的云服务器(腾讯云/阿里云)。 |
扫描出来的结果会直接保存到results里面
密探
先到tool/mitan/mitan里面再mitan
手动查询
2. 查找目标所有关联域名
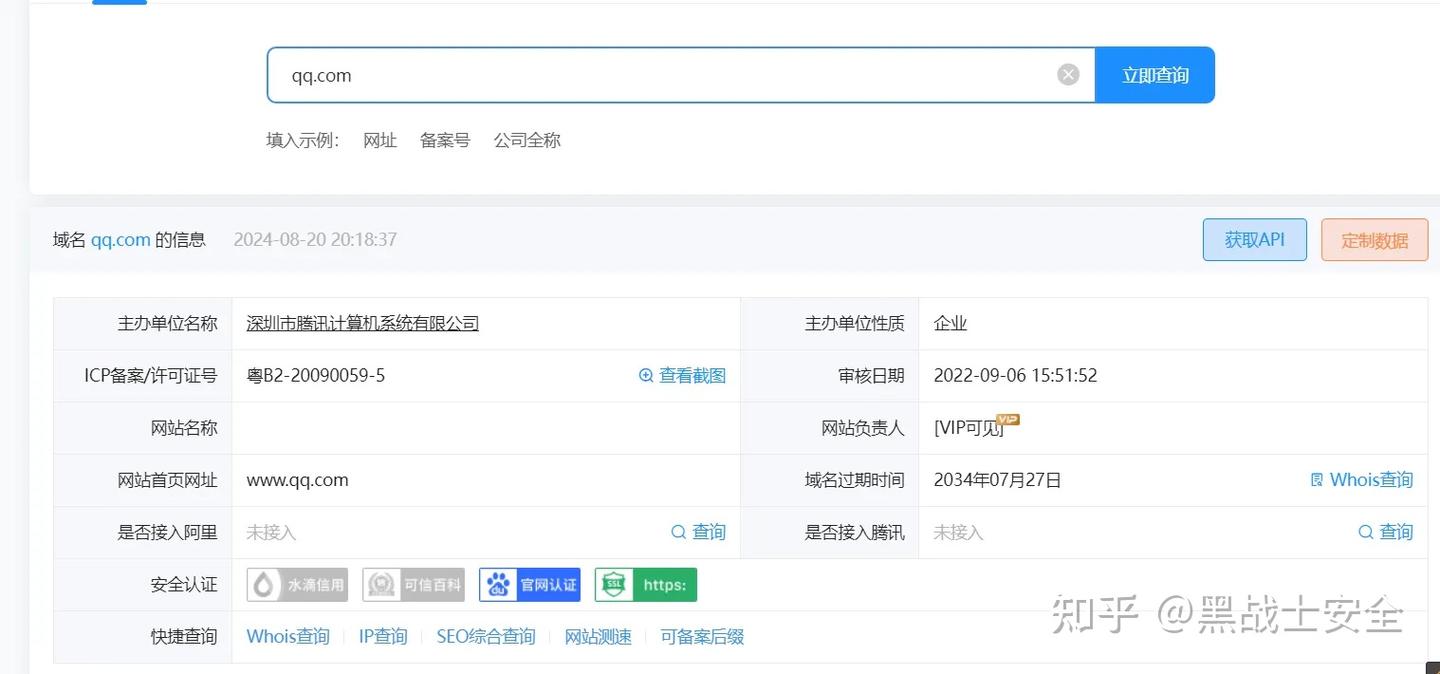
2.1 备案查询
- 官方备案网站:如工信部ICP备案系统、chinaz、等,通过主域名查备案,获得域名所属公司名称,再搜索该公司名称以获取其所有注册域名。
2.2 企业关系查询
- 企业信息查询平台:如天眼查、爱企查、企查查等,通过查看股权穿透图来查找子公司,并收集其子公司的域名。
2.3 Whois反查关联域名
- Whois查询网站:如Whois.chinaz.com,通过同一公司的域名可能使用同一邮箱注册的信息进行反查。
2.4 官网等方式查关联域名
- 官网架构图:目标企业的官网有时会列出子公司的介绍和官网链接,通过这些信息可以直接获取子域名。
3. 收集子域名
3.1 证书透明度查询
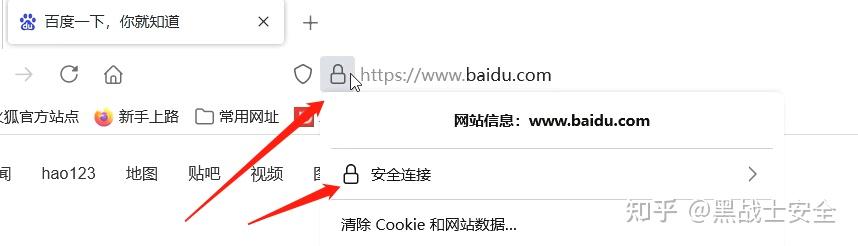
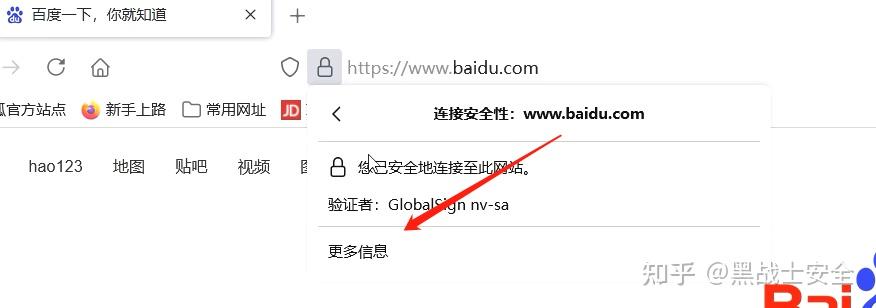
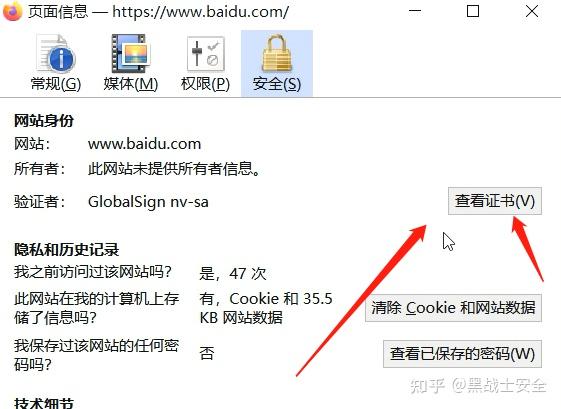
- 证书透明度查询网站:如crt.sh、Censys、SSLmate、Facebook CT等,由于许多企业域名使用HTTPS协议,TLS证书中通常包含域名信息,可以通过查询证书透明度来收集子域名。
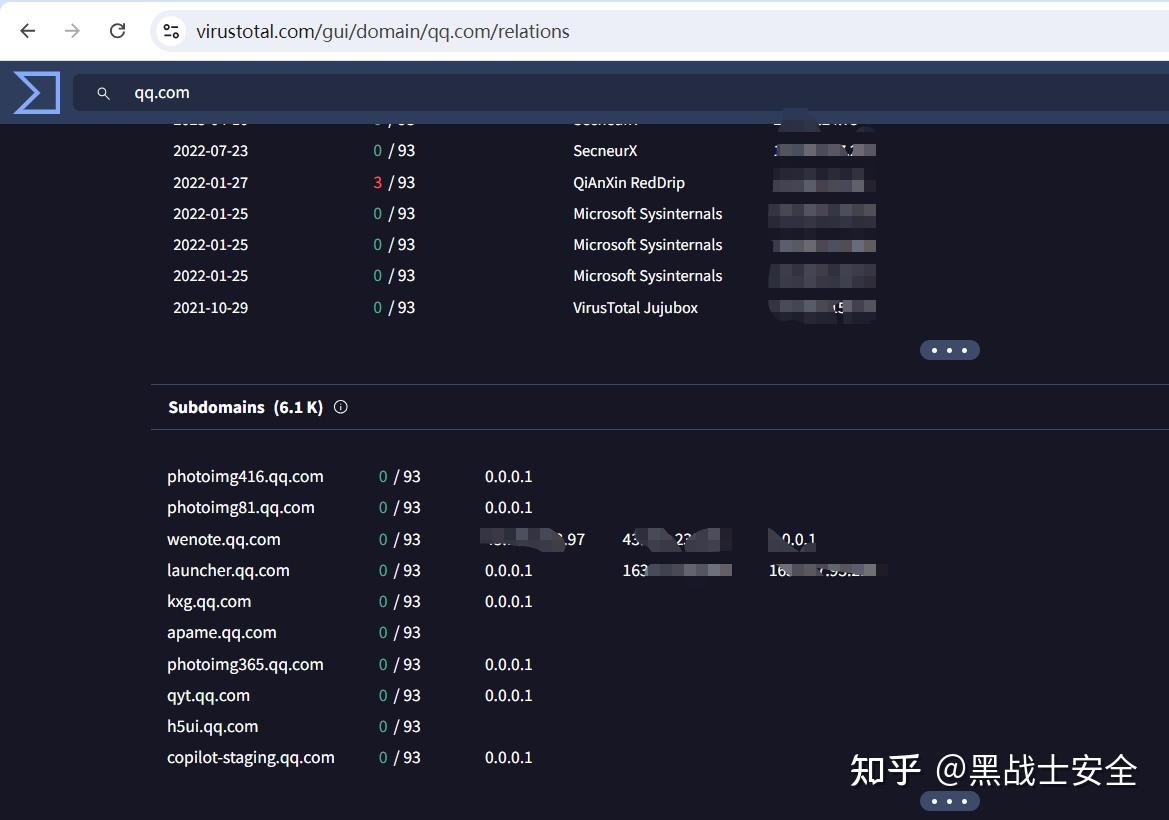
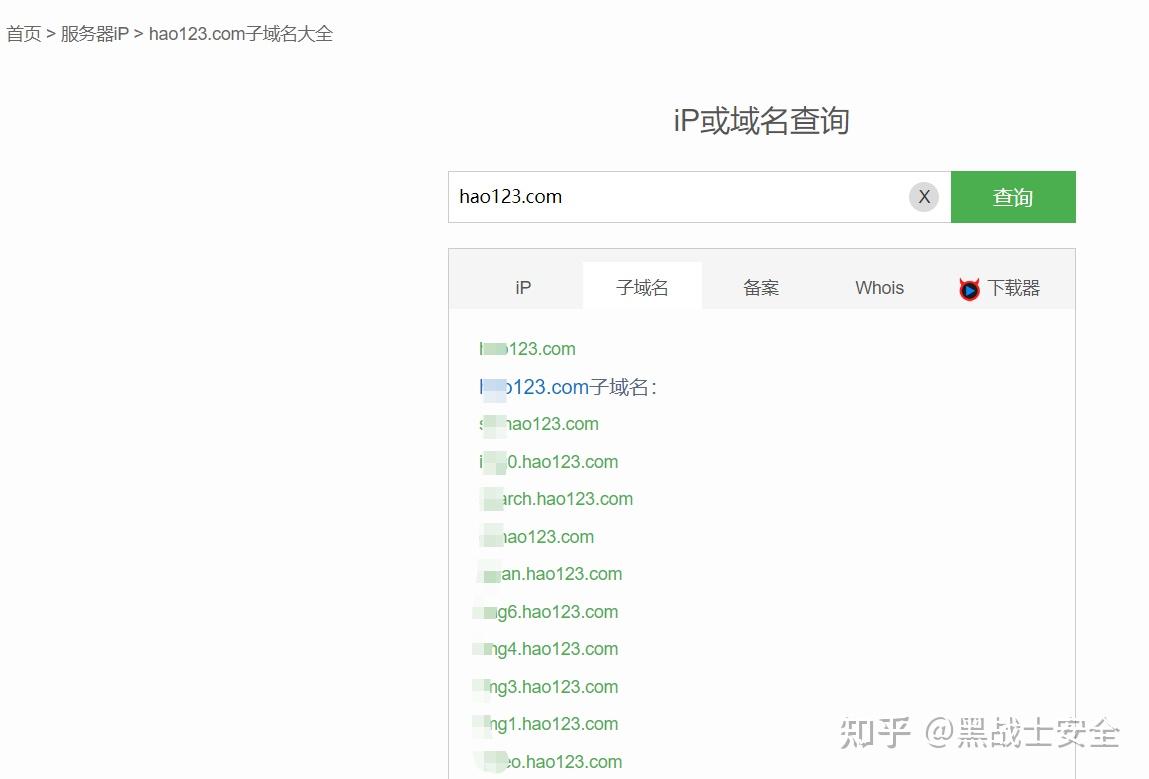
3.2 在线子域名查询网站
- 子域名查询网站:如SecurityTrails、IP138、Chinaz、dnsscan.cn等,输入域名即可获取子域名列表。
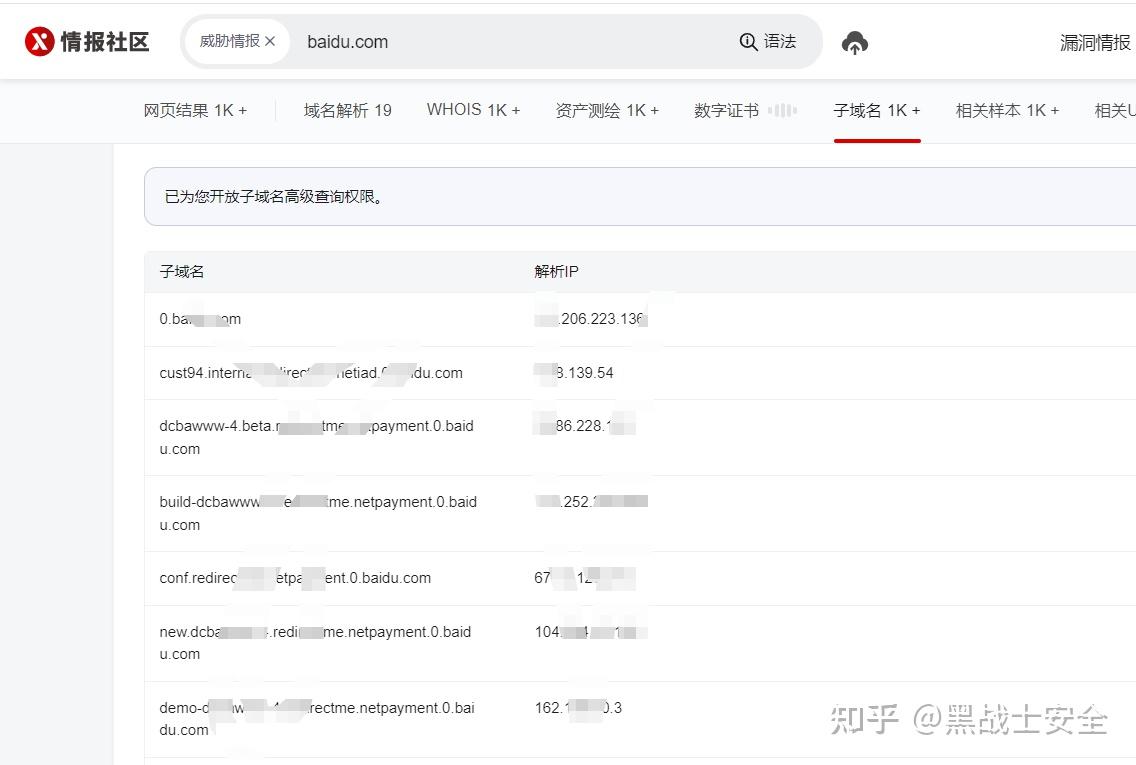
3.3 威胁情报平台
- 威胁情报平台:如ThreatBook、VirusTotal、AlienVault OTX、RiskIQ、ThreatMiner等,通过这些平台可以收集到目标组织的子域名信息。
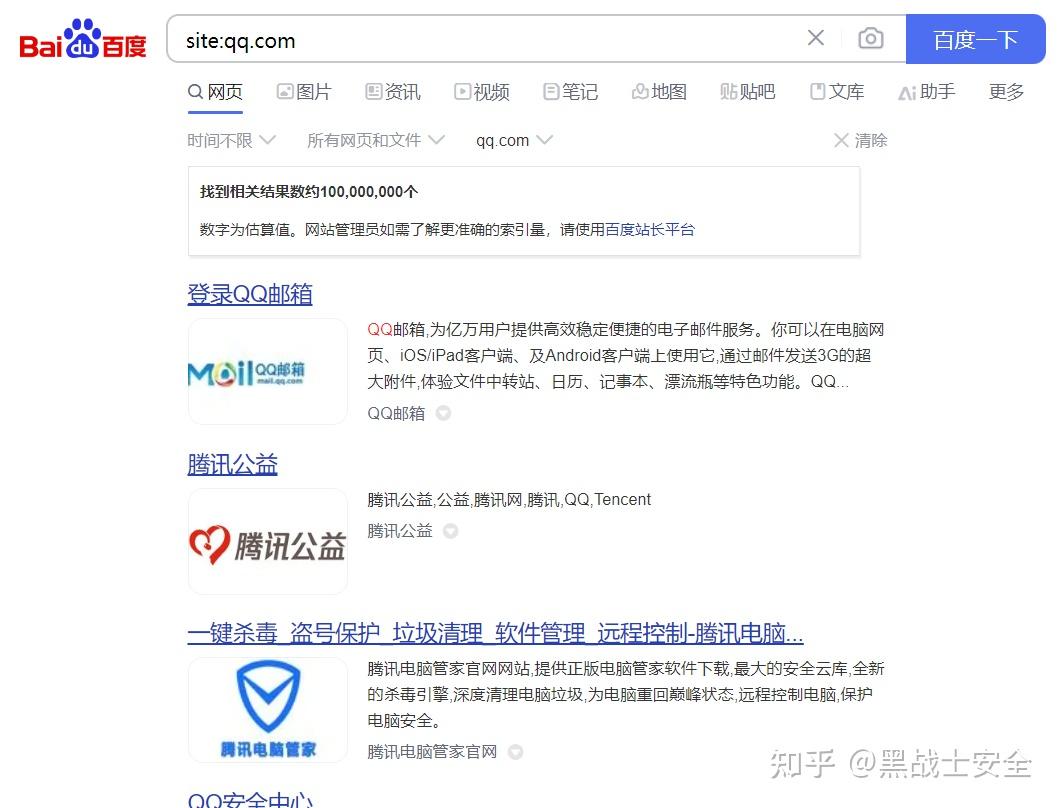
3.4 搜索引擎
- 搜索引擎语法:使用Google等搜索引擎,结合
site:语法(如site:example.com)来限制搜索结果,从而获取子域名信息。
3.5 爬虫爬取
- 爬虫技术:通过编写爬虫程序,爬取目标网站的所有页面、robots.txt文件、crossdomain.xml文件、sitemap文件等,从中筛选出子域名。
3.6 DNS记录查询
- 工具如nslookup:使用nslookup等工具查询域名的SRV、NS、MX、TXT等记录,以收集子域名信息。但这种方法收集的域名有限。
3.7 自动化工具
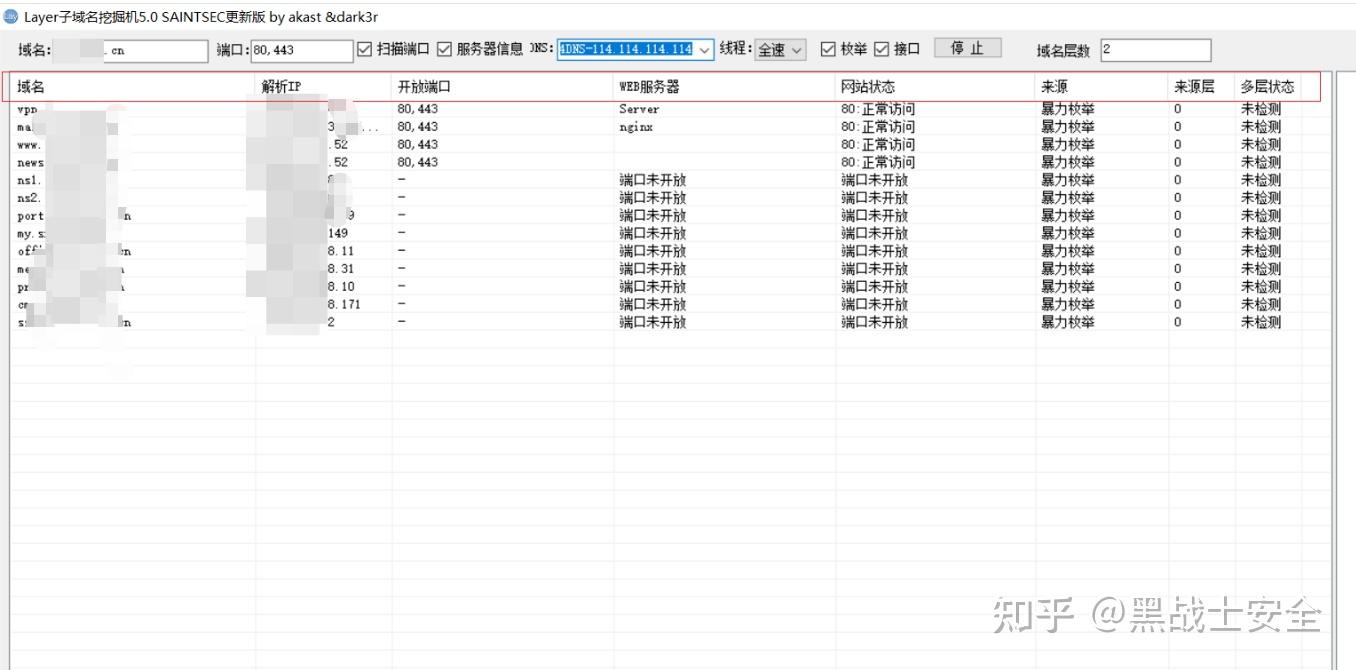
- 自动化工具:如Subfinder、OneForAll、Layer子域名挖掘机等,这些工具通过多个API和字典枚举的方式自动化收集子域名。
3.8 DNS历史记录查询
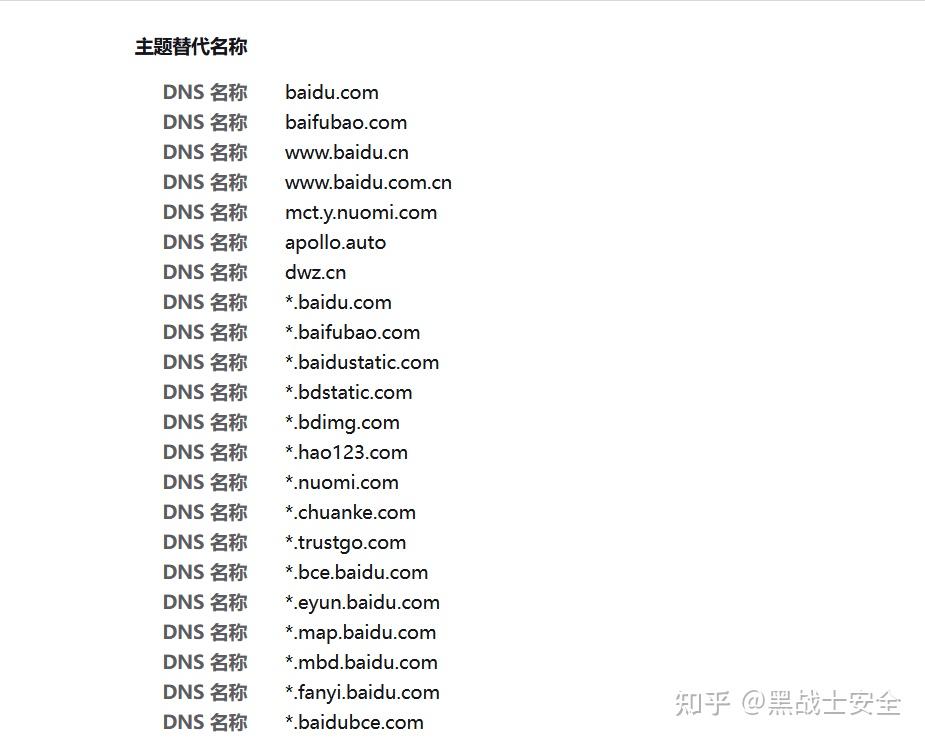
- DNS历史记录查询服务:如SecurityTrails、http://DNSdumpster.com、WhoisXML、PassiveTotal等,通过查询过去DNS解析记录的服务,可以查找目标组织过去使用过的子域名。这种方法有时能发现已被删除但仍解析到目标组织的子域名。
- 3.9 从JS文件发现子域名
- JS文件分析:许多网站在JS文件中会包含子域名的信息,通过分析JS文件可以挖掘出子域名。可以使用专门的脚本或工具(如JSFinder)来自动化这一过程。
- 3.10 子域名爆破
- 子域名爆破工具:使用如Sublist3r、Amass、Subfinder、Assetfinder等工具,通过字典或其他方法生成可能的子域名列表,并对列表中的每个子域名进行DNS解析以确定其是否存在。
- 工具推荐
- Subfinder:集成了多个API接口进行自动化搜索子域名信息,收集速度快。
- OneForAll:功能强大的子域收集工具,支持多种搜索方式。
- Layer子域名挖掘机:扫描结果依赖于字典的强大性,适合使用自定义字典进行深度挖掘。
- Sublist3r:简单易用的子域名枚举工具,支持多线程枚举。
- KSubdomain:无状态子域名爆破工具,支持高并发DNS爆破,速度快。
- 批量处理
- 对于有大量域名需要查找子域名的情况,可以通过请求API接口或使用高效的爆破工具(如KSubdomain)进行处理。但需要注意控制请求频率,频率过高会被判定为ddos攻击!
资产测活
httpx
cd到tool然后cd httpx_1.9.0_macOS_amd64进入httpx目录,测活操作就将在这里进行
1 | yuanbaoyin@yuanbaoyindeMacBook-Pro httpx_1.9.0_macOS_amd64 % ./httpx -u https://www.baidu.com |
mac系统的httpx操作命令和Windows大体上是一样的但是还是会有一些细微的区别,最前面的命令应该是./httpx然后再跟上那些基础参数
下面是一些基础参数
1 | 3.1 输入参数 (INPUT) |
其中那个-l参数就是说去那个文件里面,把文件里面包含的所有网站都测试一遍,但是这个也有需要注意的地方:
首先这个参数只认纯文本,也就是.txt的东西,并且一行只能有一个目标例如:
1 | cuit.edu.cn |
带不带 http:// 都有讲究
你的文本里写 jwgl.cuit.edu.cn,还是写 http://jwgl.cuit.edu.cn,httpx 处理起来是不一样的:
- 不带前缀(推荐): 如果你的文件里只有纯域名(比如
cuit.edu.cn),httpx 会非常聪明地同时去探测它的http://80端口和https://443端口。哪怕它关了 HTTP 开了 HTTPS,也绝对漏不掉。 - 带了前缀: 如果你的文件里写死了
https://cuit.edu.cn,那 httpx 就只会去敲 HTTPS 的门,不管其他的。
一个满配命令:
1 | ./httpx -l cuit_targets.txt -status-code -title -web-server -tech-detect -o cuit_alive.txt |
.单个目标探测
Bash
httpx.exe -u https://www.example.com //-u探测网站基本信息
2.批量目标扫描
Bash
httpx.exe -l targets.txt //-l对文件中的目标进行扫描,即扫描多个目标
3.自定义请求头
Bash
httpx.exe -u https://www.example.com -H “User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64)”
//-H使用自定义请求头
4.设置超时时间
Bash
httpx.exe -u https://www.example.com -timeout 10 //-timeout设置超时时间
5.cdn和服务器信息
Bash
httpx.exe -u https://www.example.com -cdn -web-server
//-cdn显示cdn信息,-web-server显示web服务器信息
6.状态码 过滤
Bash
httpx.exe -l .\url.txt -fc 403,404
//-fc过滤指定状态码
7.配置随机UA头部
Bash
httpx -u https://www.example.com -random-agent -no-decode
//–random-agent启用随机User-Agent头, -no-decode避免解码响应体
8.显示状态码信息
Bash
httpx -l url.txt -sc //-sc显示状态码
常用组合命令
1.批量探测1
Bash
httpx.exe -l url.txt -cdn -web-server -fc 404,500 -o output.txt -random-agent -timeout 10
2.批量探测2
Bash
//批量二:探测成功的url输出
httpx.exe -l url.txt -cdn -fc 404,500,400,403 -o output.txt -random-agent -timeout 10
dddd
开启方式:
先一直cd到tool下面的dddd里面去
1 | yuanbaoyin@yuanbaoyindeMacBook-Pro dddd % ./dddd_darwin_arm64 -h |
指纹识别
简单来说就是一个网站的一些基础信息,通过这一步好为我们后面的渗透进行进一步的铺垫,这其中就包括对方使用的什么框架,比如thinkphp;再比如对方使用的什么编程语言,以及使用什么版本的软件搭建起来的
脆弱资产
脆弱资产其实就是指的那些暴露在公网上的,但是没人管或者属于管理又或者配置问题导致防御十分脆弱的资产
一些杂项
网站时光机:
这是一个通过大量爬虫对全球网站进行截取的网站,我们可以在这个网站里面看见很多过往的网站信息,比如十年前的cuit,有时我们可以利用这个网站进行信息搜集,因为可能管理员在几年前时由于自己的疏忽就直接把一些关键信息直接放在了当时的网站里面,那我们这个时候就可以利用这个网站尝试去以前的网站里面尝试抓取一些重要信息