简介
CB链相比之下是一个比较简单的链子了,简单来说就是BeanComarator类下有个compare方法,它需要两个对象,然后会根据我们在实例化BeanComparator时给构造方法传的参去两个实例化对象中对应取出来,而TemplatesImpl类的getOutputProperties方法会调用newTransformer,然后剩下的其实就和cck1一样了
原理
首先就是为什么要叫做CB链,其实和CC链一样,这里我们要用的库是Commons Beanutils 库,然后在java当中存在一种书写规范叫做JavaBean,这个书写规范的要求简单一些来说就是:一个属性私有、有getter和setter,并且实现了Serializable的类
假设我们有一个属性是name:
取值(Getter): 方法名必须是 get 加上属性名(首字母大写),所以叫 getName()。
赋值(Setter): 方法名必须是 set 加上属性名(首字母大写),所以叫 setName()。
下面就是一个简要的符合javabean的类:
1 |
|
CB库中提供了一个PropertyUtils.getProperty方法,让使用者可以直接调用任意Javabean的getter方法,getProperty方法
需要两个参数,第一个参数就是类对象,第二个参数就是属性名
此时,commons-beanutils会自动找到name属性的getter方法,也就是 getName ,然后调用,获得返回值
说完上面的,接下来就是链子了,我们在CB链当中用的是CB中的,BeanComparator类,这个类有个compare方法: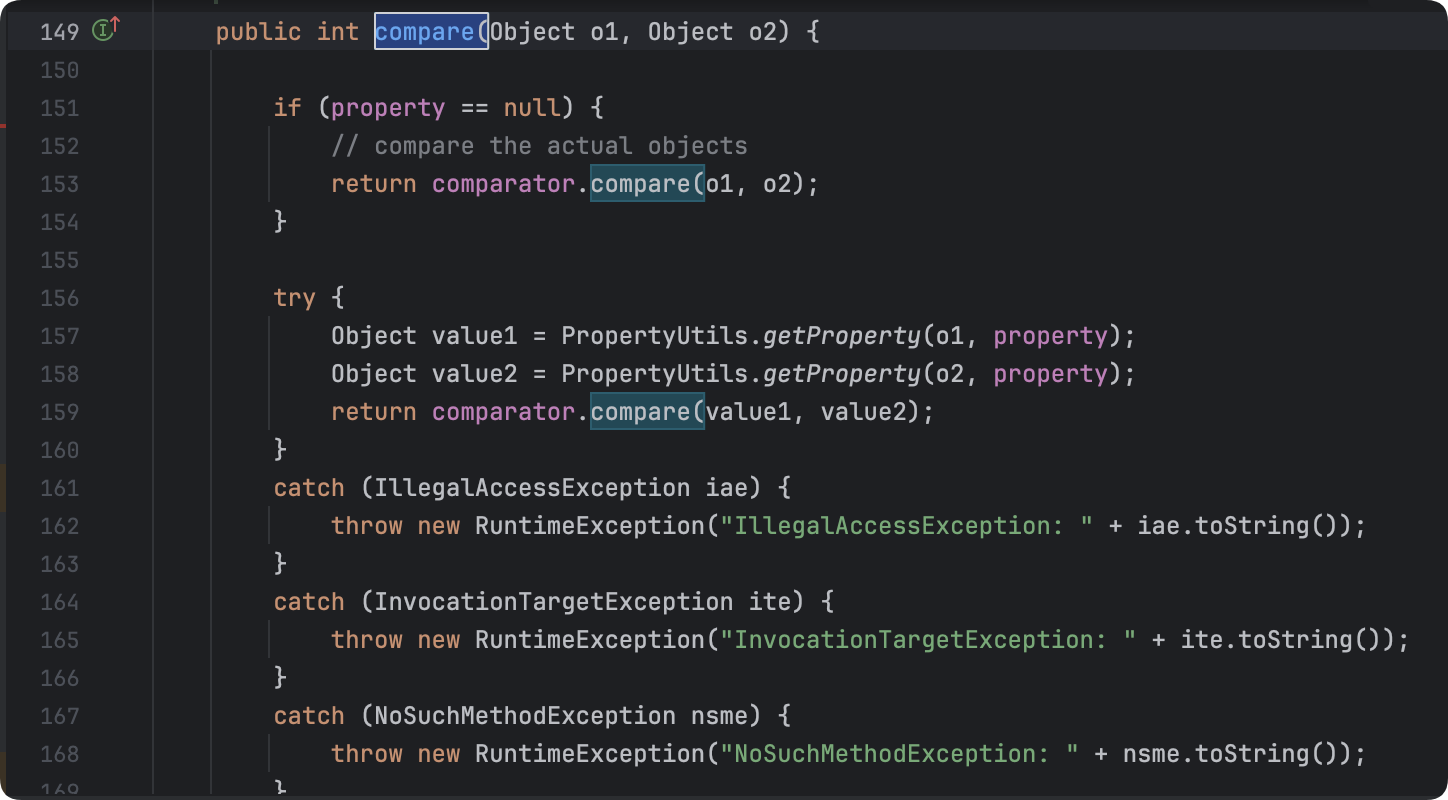
这个方法当中写到,如果我们传入的两个对象是null那就直接比较,但是如果 this.property 不为空,则用 PropertyUtils.getProperty 分别取这两个对象的 this.property 属性,比较属性的值
而在TemlatesImpl类当中的getOutputProperties方法当中也写到:
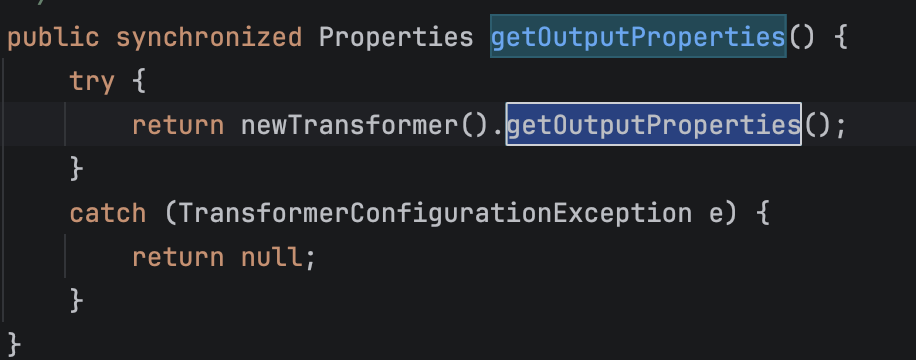
那这里出现了newTransformer了,这不就和CCK1一样的吗,剩下的其实就是CCK1的东西了,这里就不多说了
构造
最主要的就是这部分:
1 | BeanComparator bc = new BeanComparator(); |
这里的setFieldValue还是我们自己写的方法,和CCK1的时候一样。
这里需要还需要学习以下的是PriorityQueque这是一个优先队列,那么这里为什么要用到这个类呢?
我们从这个类的readObject()方法入手开始看:
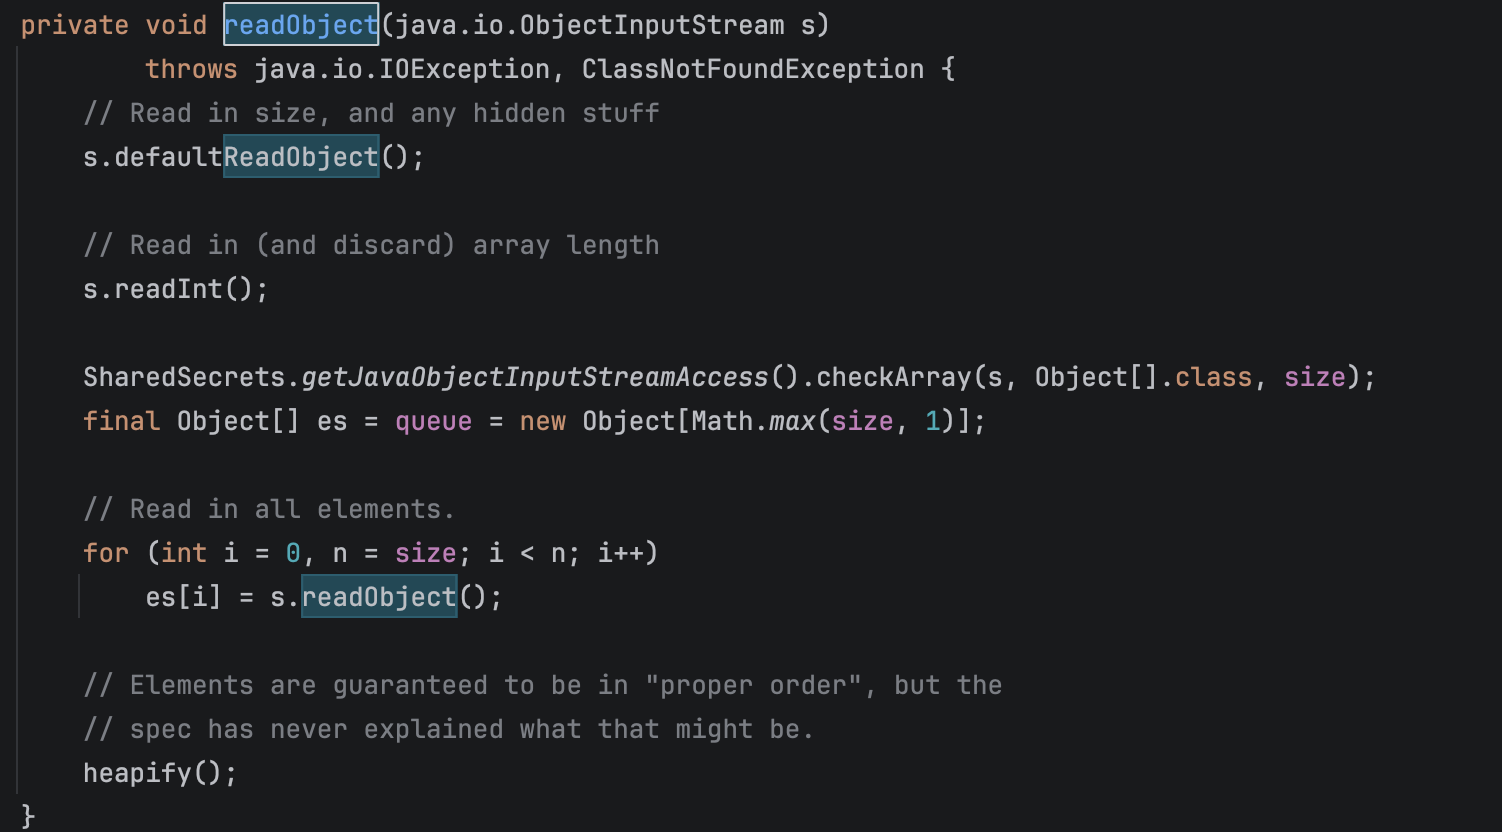
其实这个readObject方法里面写了很多,其中有一个queque数组,这个数组是PriorityQueque用来装数据的数组,和我们这条链子有关系的就只有最后一句heapify():我们跟进一下:
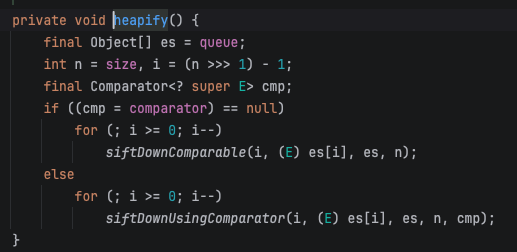
我们看到:
1 | if ((cmp = comparator) == null) |
这个就是在查这个队列有没有自带比较器,这里的比较器其实就是我们在实例化时给构造方法传参时传进去的类有没有实现Comparator接口,而我们传进去的这个类就需要在Priority当中充当一个裁判的作用。
明显我们通过代码也看的出来这里我们是有比较器的,那么就会往
1 | siftDownUsingComparator(i, (E) es[i], es, n, cmp); |
我们跟进一下: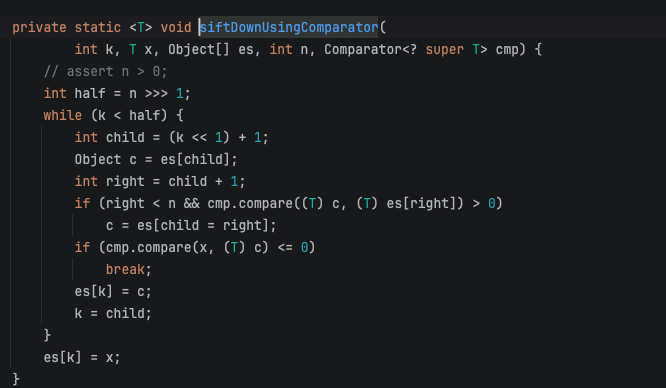
这里面的x和c就是在es提取出来的具体元素,而es就是queque数组,cmp就是我们传的BeanComparator
仔细看截图里的 while 循环,里面有两次极其致命的函数调用:
- 第一处:
if (right < n && cmp.compare((T) c, (T) es[right]) > 0) - 第二处:
if (cmp.compare(x, (T) c) <= 0)
这里我们可以看见执行了比较器的Compare方法,上面我们又说了BeanComparator类的Compare方法会去调用CB库底层的PropertyUtils.getProperty从而进一步去调用getter,而我们说了getOutputProperties方法会调用newTransformer方法,此时就形成了完整的链子了。
那么我们回到代码:
1 | BeanComparator bc = new BeanComparator(); |
第一句实例化我们的比较器,第二句实例化我们的PropertyQueque,并且给构造方法传参,意思是创造一个有两个元素的队列,比较器是BeanComparator的实例。
然后三四句就是我们往里面放元素,这里简要的概括一下优先队列当中的readObject的逻辑,它的逻辑简而言之就是如果这个队列有两个或者两个以上的元素就会把比较器拿出来比较一下方便排序,所以我们这里就塞两个没用的数据1进去,为什么这里要放1呢,其实还是怕我们构造的炸药提前就炸膛了。
我们为了不炸膛就还是沿用我们一贯的方法,先瞎塞一个,然后后面再去给改回来
- 替换比较器的目标属性
1 | setFieldValue(bc, "property", "outputProperties"); |
在正式替换这行代码之前,我们通常会先通过 pq.add(1) 的方式,往队列里塞入两个无害的数字,目的是把队列的 size 撑到 2,以满足后续反序列化时触发排序比大小的条件。
如果不用反射,直接传参会怎样? 如果我们在最开始实例化比较器时,直接写成 new BeanComparator("outputProperties"),那么在后续执行 pq.add(1) 占位时,优先队列会自动触发内部排序。此时,比较器会去尝试获取数字 1(Integer 对象)的 outputProperties 属性。显然 Integer 类中不存在这个属性,程序会当场抛出 NoSuchMethodException 异常,导致 Payload 还没生成就直接崩溃了。
因此,正确的做法是:先创建一个没有指定属性的“空壳”比较器骗过本地的排序机制,等占位完成后,再利用反射悄悄将底层变量 property 替换为真正的致命引信 "outputProperties"。
- 偷换队列底层的恶意对象
1 | setFieldValue(pq, "queue", new Object[]{tmpl, tmpl}); |
此时,优先队列的架子已经搭好,里面的元素是之前用来占位的两个 1。接下来要把它们换成真正的恶意对象 TemplatesImpl(即 tmpl)。
为什么不能直接调用 pq.add(tmpl)? PriorityQueue 的 add 方法底层自带重排逻辑。如果我们通过正规的 add 方法向队列中添加恶意对象,队列在接收到数据的瞬间就会在本地环境触发比较器。此时比较器已经被我们改成了真引信,它会毫不犹豫地调用 tmpl.getOutputProperties(),直接导致咱们自己的电脑弹出了计算器,而真正的受害者毫发无损。
为了绕过这个本地触发机制,我们必须放弃使用正常的 API,直接利用反射强行修改 PriorityQueue 底层用来存储数据的私有数组 queue,将原先装有 [1, 1] 的数组直接替换成装有 [tmpl, tmpl] 的新数组。
总结 通过这两次关键的反射操作,我们在本地内存中强行拼凑出了一个随时会爆炸的优先队列,但又完美绕过了所有会触发排序的正常方法。这个 Payload 在本地处于绝对休眠状态,只有当它被发送到目标服务器,并在目标的 readObject 流程中自动调用 heapify() 重新排序时,才会真正展露杀机。
下面给出完整的poc:
1 | package com.Yu9991n9; |